
想到去年fic还是我打的第一个取证比赛,那今年的FIC也算是一周年纪念日了
一、计算机取证
1. 分析计算机检材,操作系统版本号为
这一套的计算机比较少见,是Linux系统的
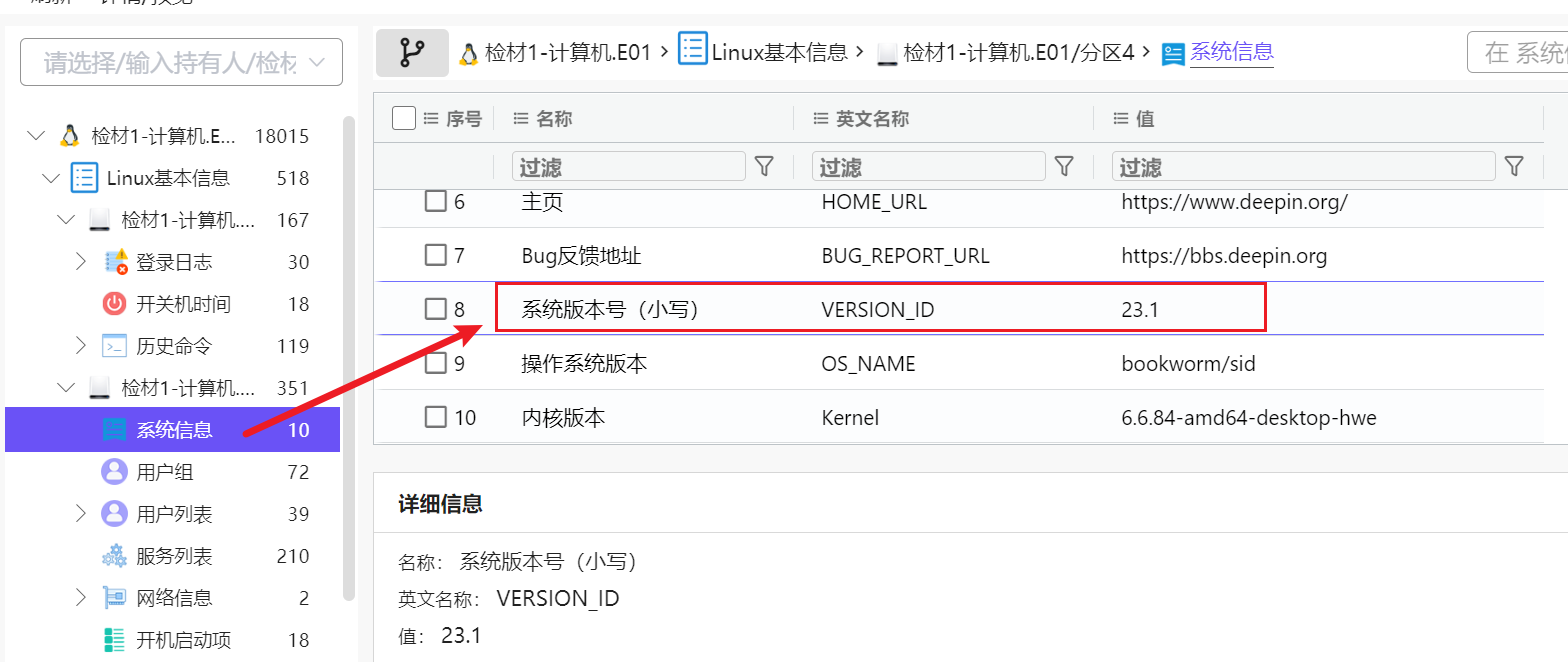
不过我们分析完还是可以直接在系统信息一栏找到我们的系统版本号是23.1
2. 分析计算机检材,李安弘曾收到一份免费领取token的邮件的疑似钓鱼邮件,其发送用户邮箱为
既然说了是邮件,我们肯定是去找邮件了

免费领取token,这一份邮件和题目高度贴合,肯定是这个啊,可以看到发件人是hf13338261292@outlook.com
3. 分析计算机检材,李安弘电脑中记录的黄金换现金的商家联系方式为
看起来是会存在备忘录通讯录一类软件的内容,我们在火眼没有直观看见
既然如此就先仿真吧,这边仿真就是直接火眼仿真,没什么卡顿
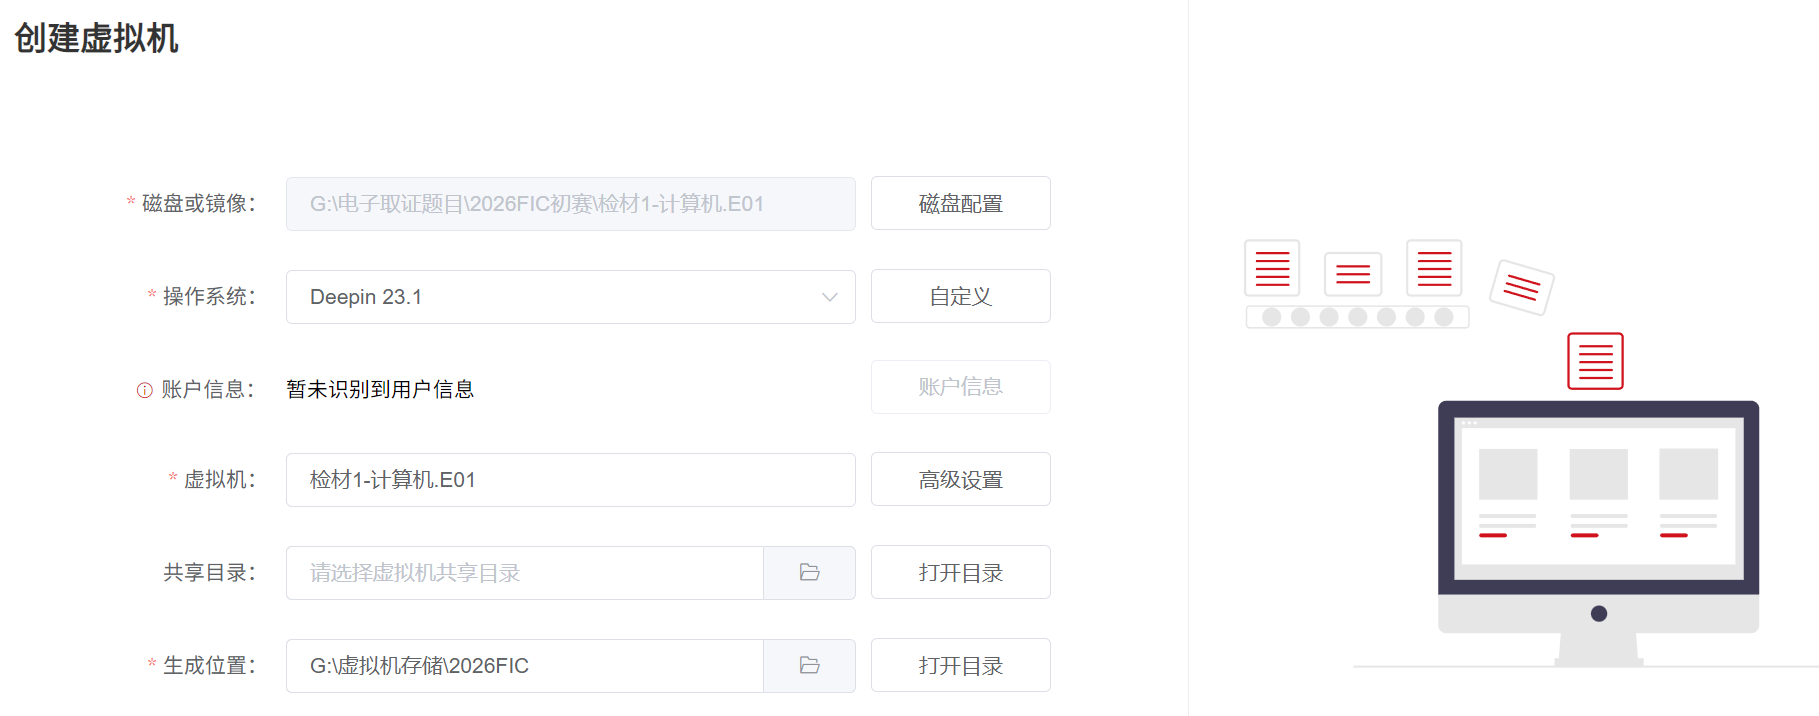

打开来可以看到我的常用里边有一个语音记事本
(不得不说这个ui好好看)
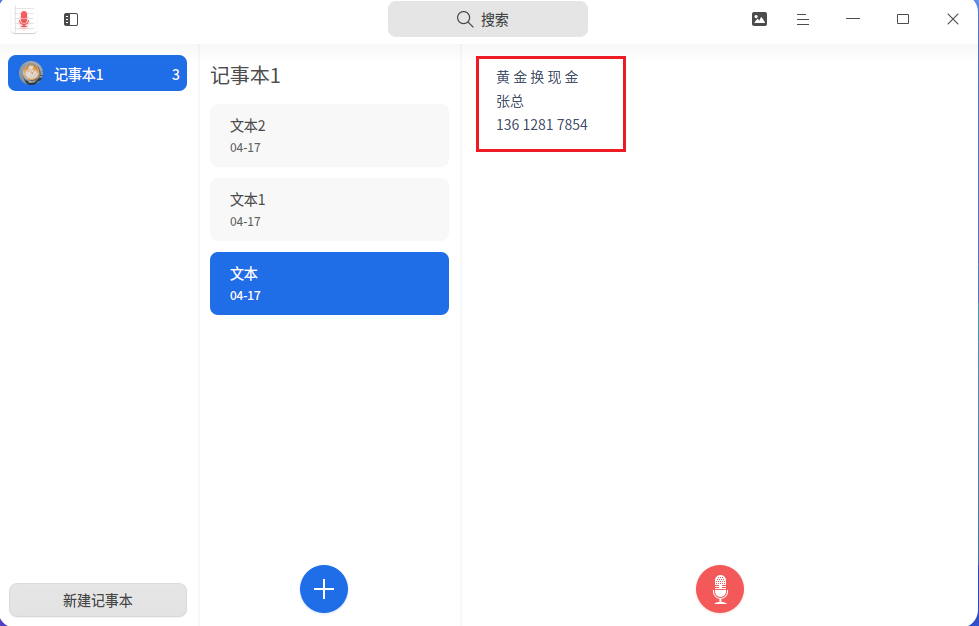
打开来就能看见记事本了
黄金换现金的手机号是13612817854
4. 分析计算机检材,推广设计图中的apk下载链接为
意思是我们要先找一个叫做推广设计图的东西

直接搜索推广设计图发现有结果,在下载一栏里

本来发现是.enc结尾的以为解密会很复杂,没想到这边直接把解密的html放在同路径了
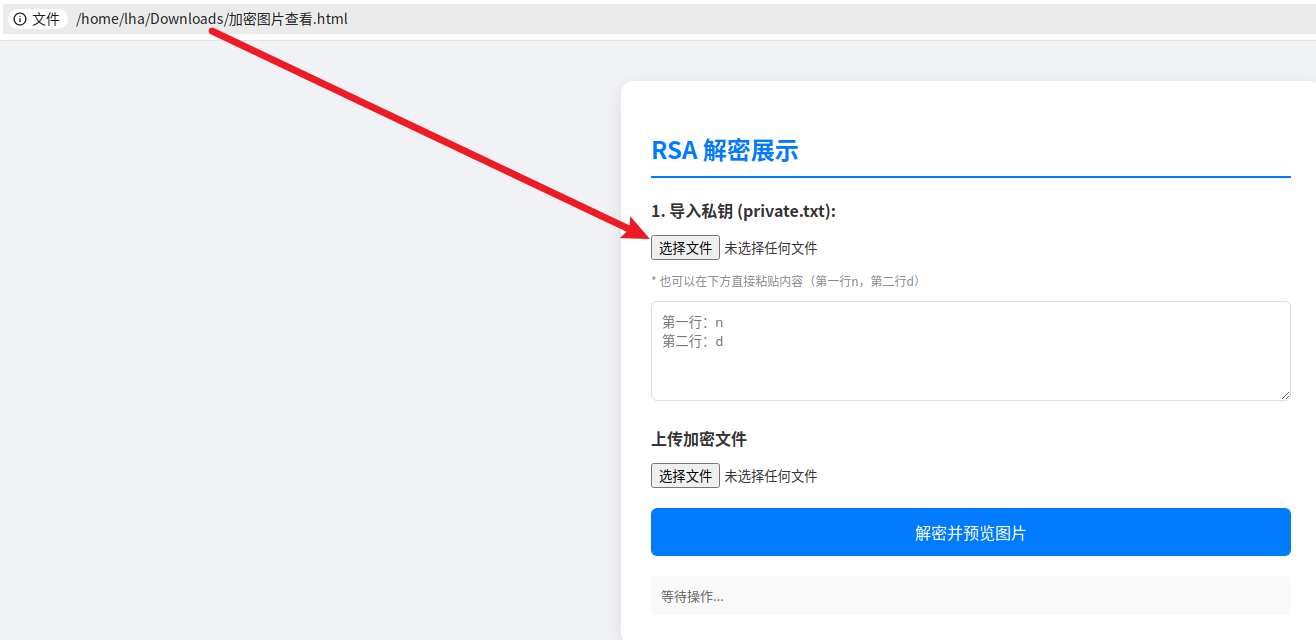
我们如今只差一个私钥了,要我们的n和d

打开public.txt,发现了两行内容,明显是RSA的公钥n与e
如今我们n也有了,只差一个d,算出d即可,一道小的RSA题目,弱点在于p和q太接近,所以直接可以Fermat分解,很快
from math import isqrt

n = 57751892008149574447756694613209346511056045951970458143905594411398554113111623746466692172544473909892773600617029641656248235151775166339061269972238018743173330948084699695182438765935110193323089354031112350869626121317836465551360104372140181097747761558797918522051881262043738603183528521379831286761
e = 65537

a = isqrt(n) + 1
while True:
    b = isqrt(a*a - n)
    if b*b == a*a - n:
        p, q = a-b, a+b
        break
    a += 1

d = pow(e, -1, (p-1)*(q-1))
print(d)

成功得到d,与n一起填入解密
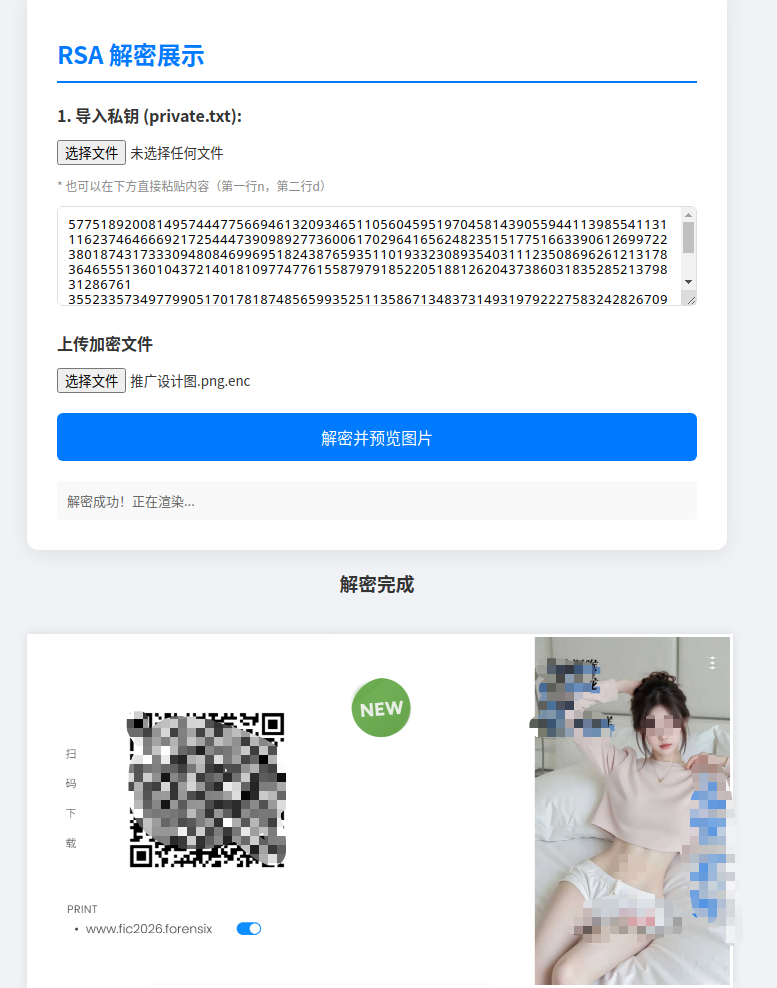
(原图没这些码,内容有点十八禁,我打码了)
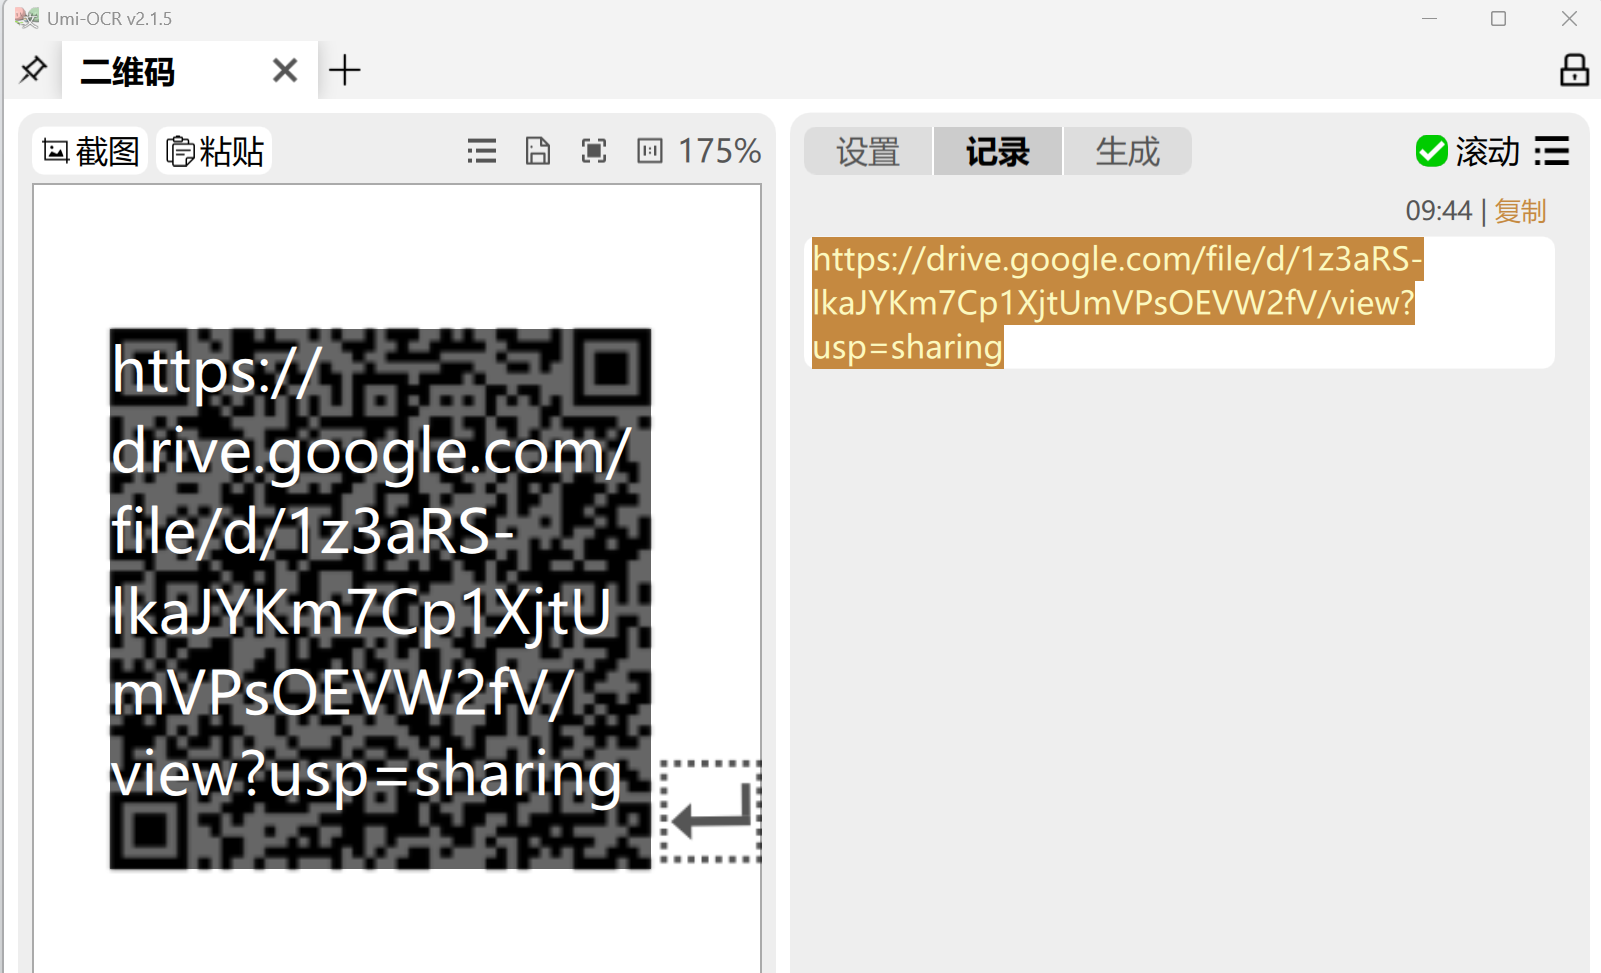
扫码得到apk的下载地址
即本题答案https://drive.google.com/file/d/1z3aRS-lkaJYKm7Cp1XjtUmVPsOEVW2fV/view?usp=sharing
5. 分析计算机检材,李安弘电脑vpn软件开放的代理端口为
刚刚找备忘录的时候一眼就看见这个vpn软件了

打开来就能看代理端口了
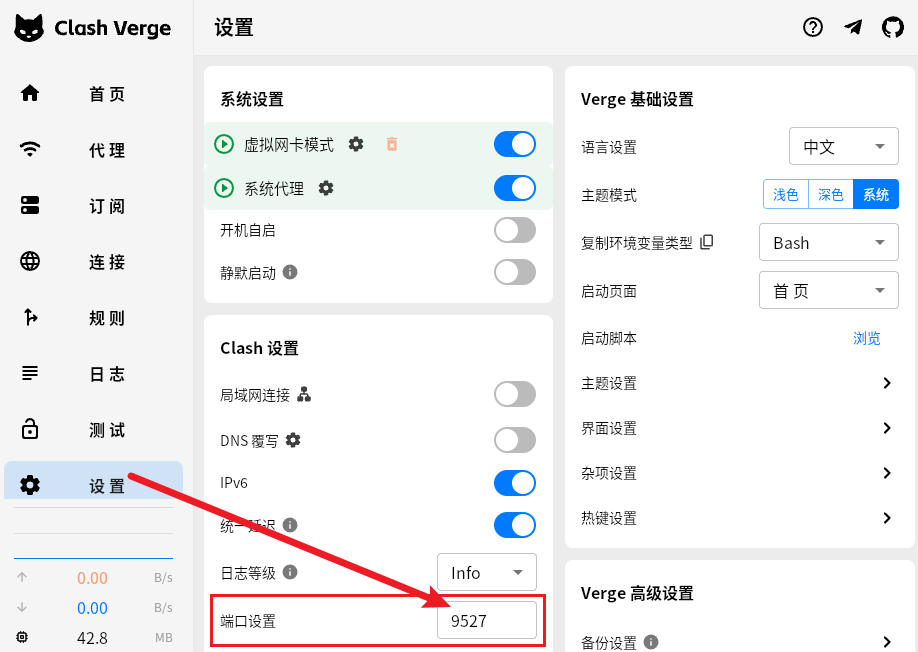
发现端口是9527
6. 分析计算机检材,李安弘电脑中AI软件当前使用的模型类型为
那肯定是先找AI软件哇
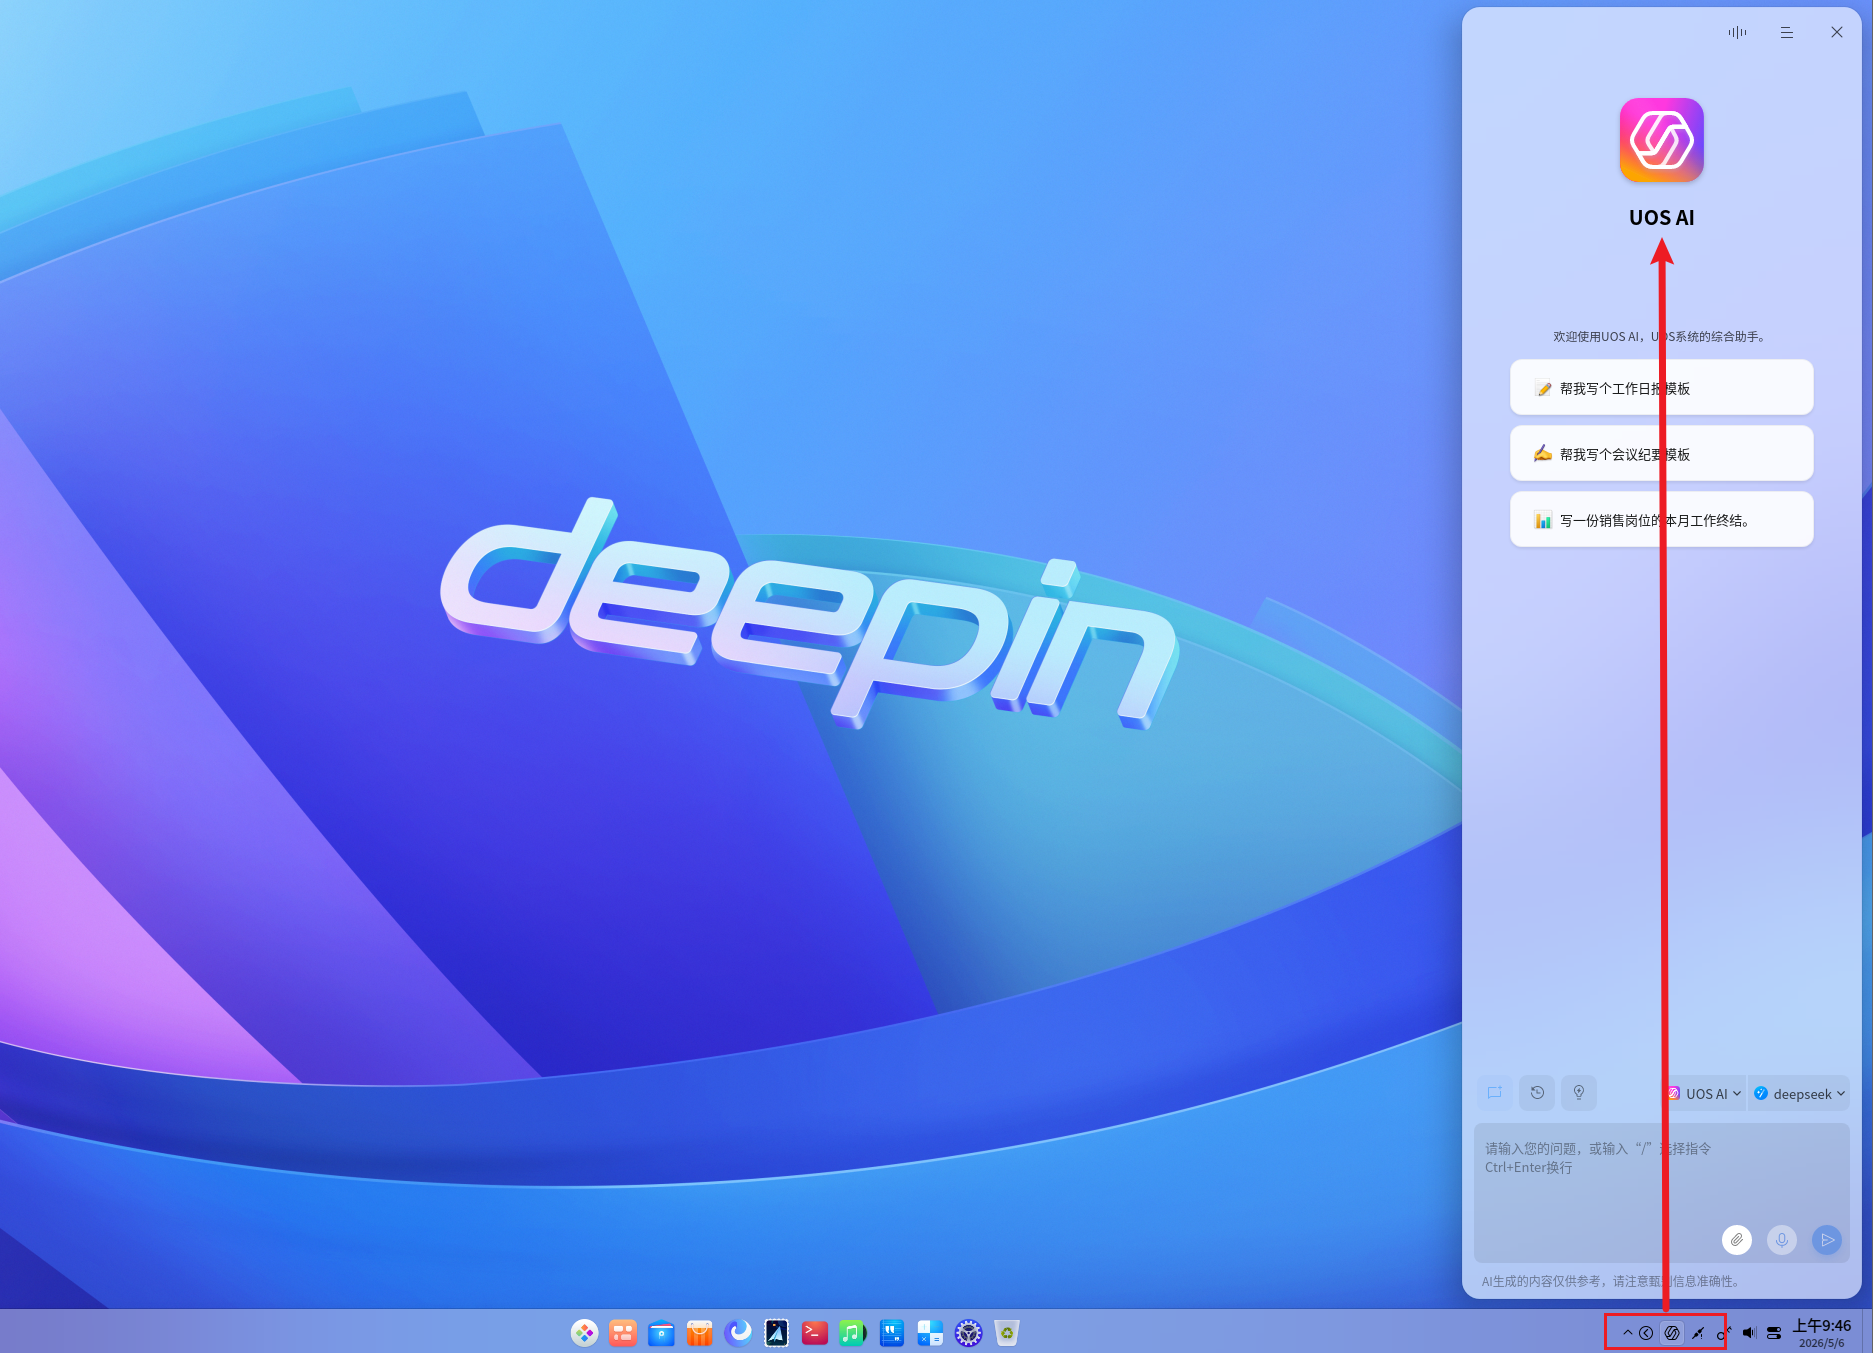
桌面这边就开着一个UOS AI,就在右下角,打开确认了的确是AI软件
看看模型类型

打开设置
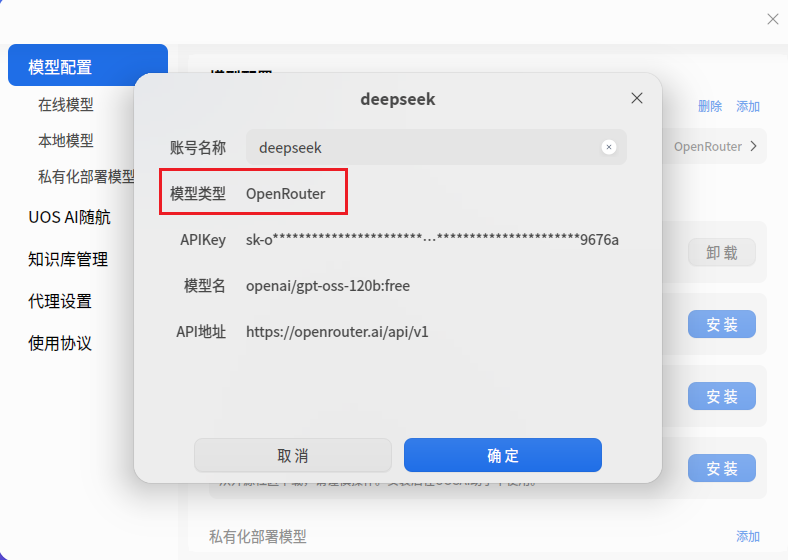
所以模型类型是OpenRouter
7. 分析计算机检材,李安弘电脑中AI软件当前使用的模型apiKey为

上一题有写,但是加码了,看不见全部的apiKey
那只能去配置文件里边找了,找找这个UOSAI的配置文件在哪里
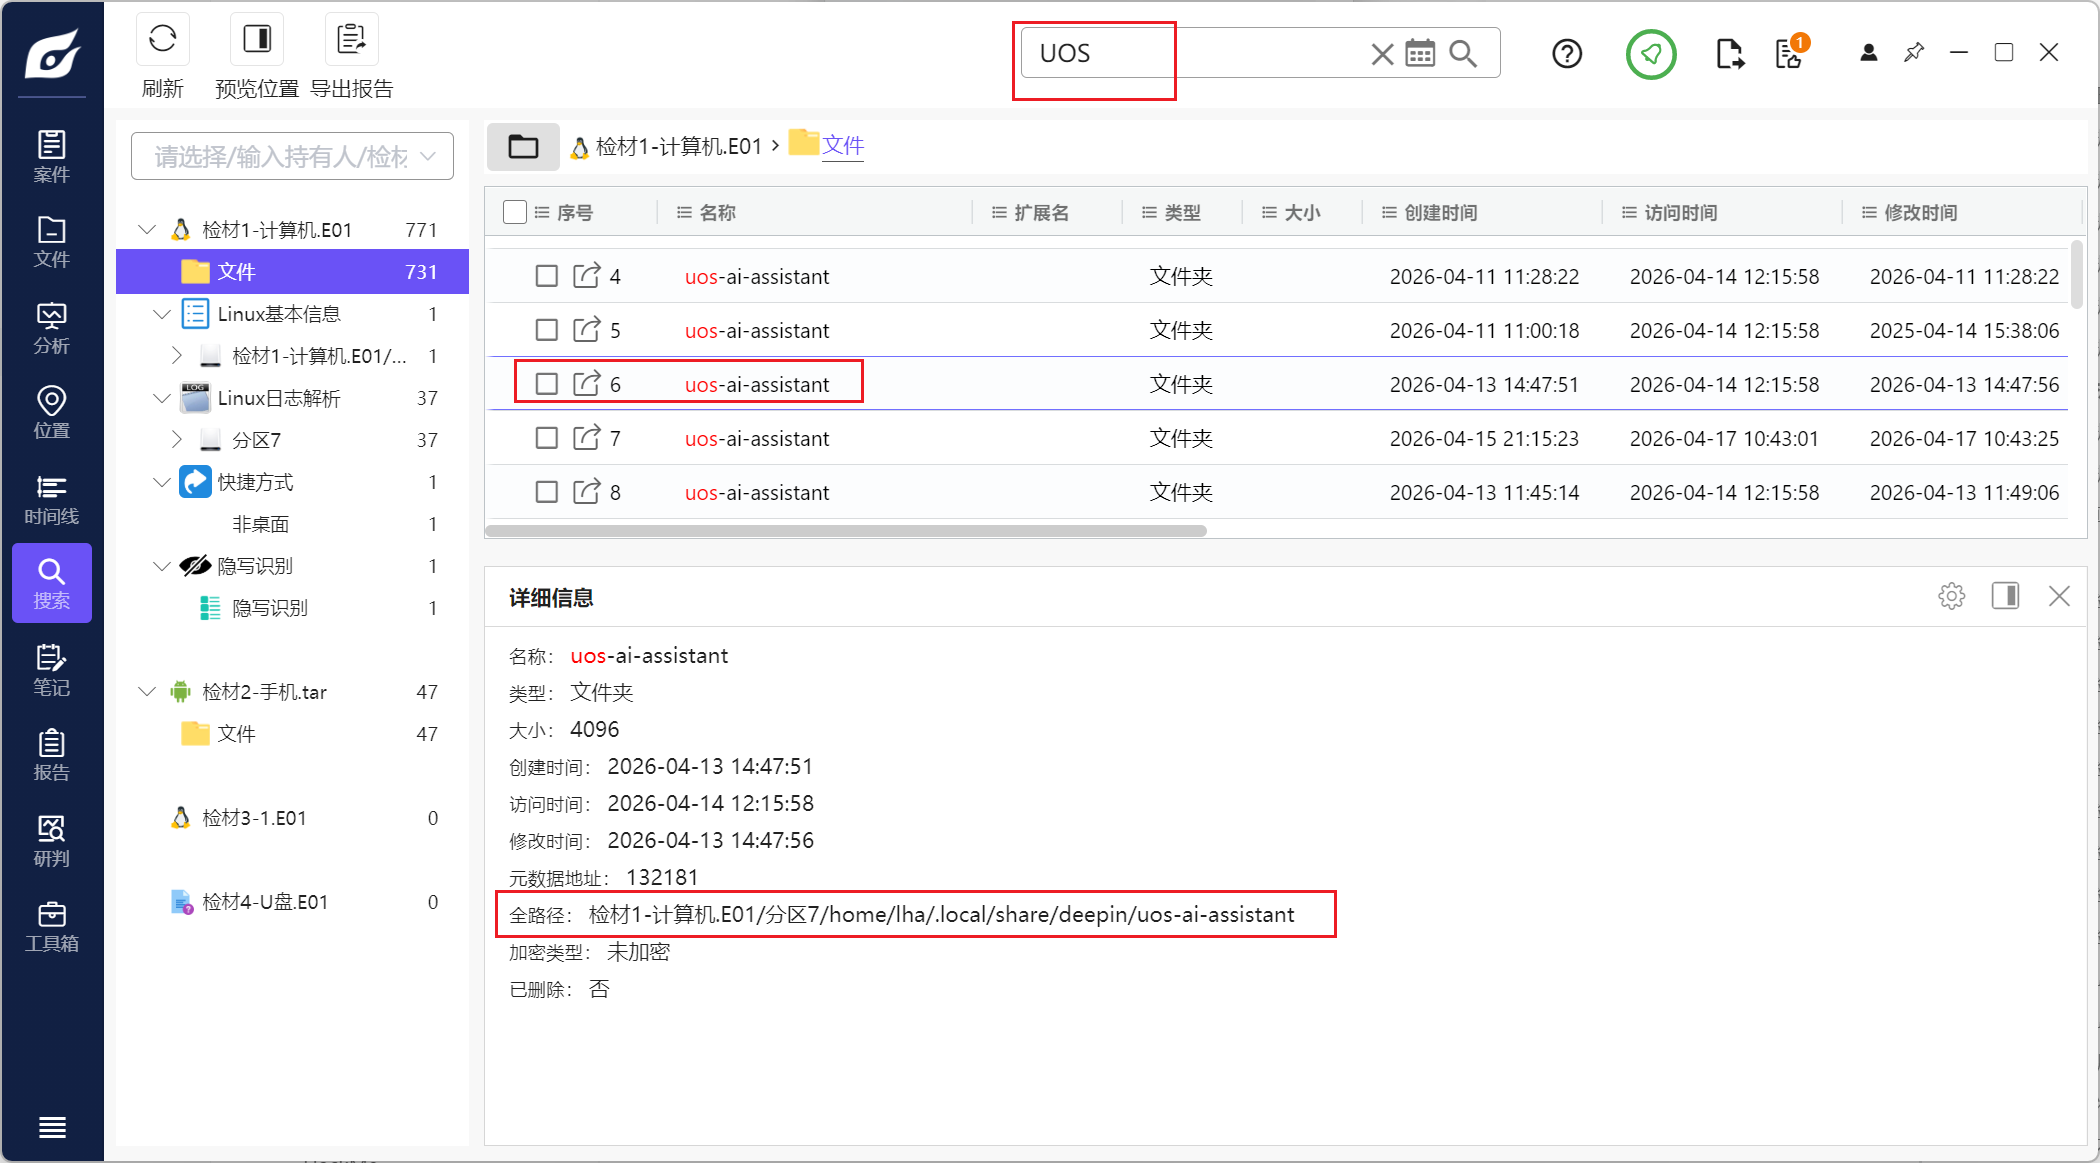
搜一下UOS,大小降序,一般这种都放在家目录,去看看

发现了在数据库里有写llm的apikey
{"apiKey":"sk-or-v1-f501ba...676a","apiSecret":"","appId":"","socketProxy":{"host":"","pass":"","port":0,"socketProxyType":0,"user":""}}
所以答案是sk-or-v1-f501ba...676a,也可以和之前的比较一下,发现正确,答案就是这个了
8. 分析计算机检材,李安弘电脑中勒索软件提供的解密服务联系方式为
找勒索软件其实第一想法就是去邮件找

我们又知道这边有一个什么token免费领,一看就是个钓鱼下载,像勒索
看看url可以知道这玩意让你直接下载加执行权限然后直接运行这个get_token_linux
到时候你直接运行他给你全锁上然后勒索你钱财

但是找了半天没找到这玩意在哪里,怀疑是VC加密隐藏起来了

因为我们之前刚刚扔到火眼就跳了需要VeraCrypt解密的提示
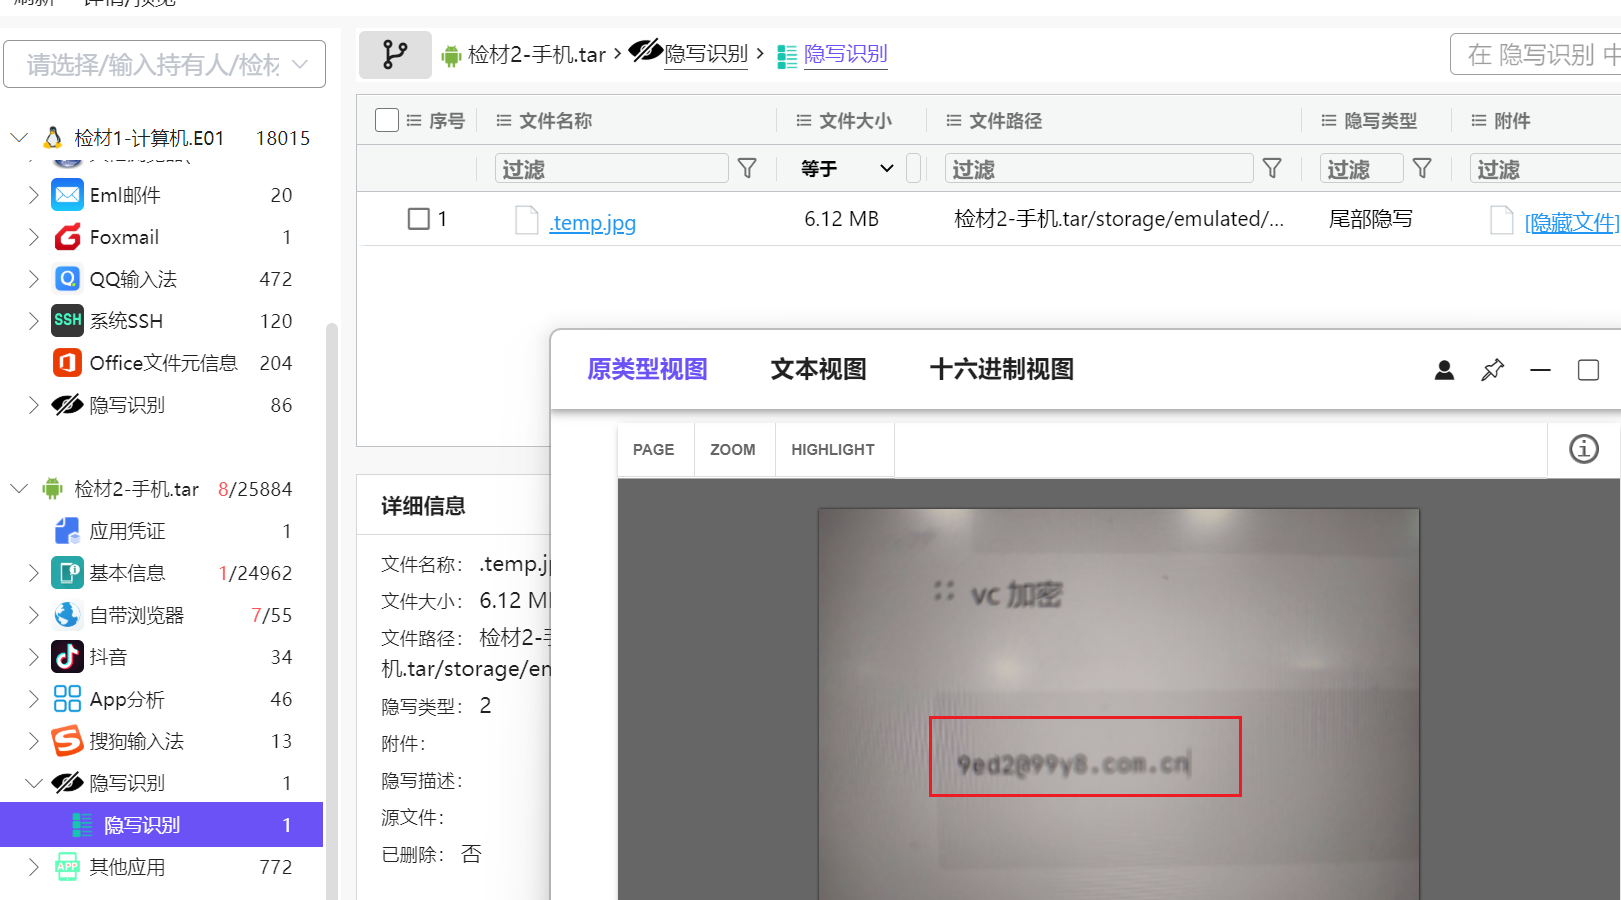
而在开赛前就能在手机找到一个隐写识别,所以明显这个VC密码是属于这边的,我们直接先填上,避免后续遗忘,这种各个检材联动其实是很常见的,虽然这套考的不是很多
vc密码:9ed2@99y8.com.cn

按道理来说我们直接扔到火眼里边就会像这样子解密了,但是我想很有可能会有人跟我一样写了密码显示解密失败,那这样子怎么做呢?
我们其实也可以手动解密的

直接把分区三扔到vc然后输入密码就好了
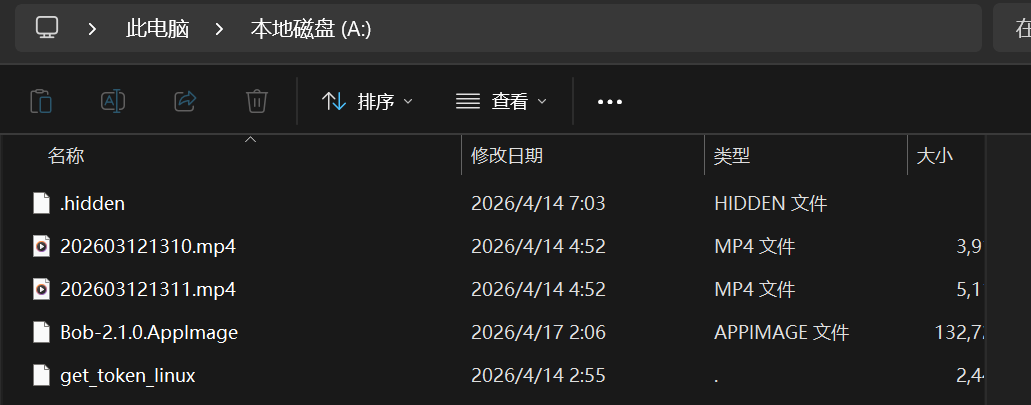
发现了五个文件,发现有一个和我们思路完全符合的get_token_linux
ida打开看看,推荐用高版本ida打开,我是9.2,因为是go语言编写的程序

可以在main_main看见
*(_QWORD *)v4 = 0xAFE886AFE5A3A7E8LL;
      v5 = 0xBBB3E7BBB3E720B7LL;
      qmemcpy(v6, "beijixin996@tutanota.com", sizeof(v6));
上边两行小端序转UTF-8
得到内容:' 解密请 系系beijixin996@tutanota.com '
所以本题答案联系方式就是beijixin996@tutanota.com
9. 分析计算机检材,李安弘电脑中记录的存放黄金的保险柜编号是
在刚刚的vc解密出来的内容里可以看到有俩mp4,程序里又有写关于mp4的内容

怀疑里边藏着一些内容,但是打不开,可能是被get_token_linux给加密了
我们继续研究这个程序

可以看到就是把目录的.mp4文件扔到main_a加密了
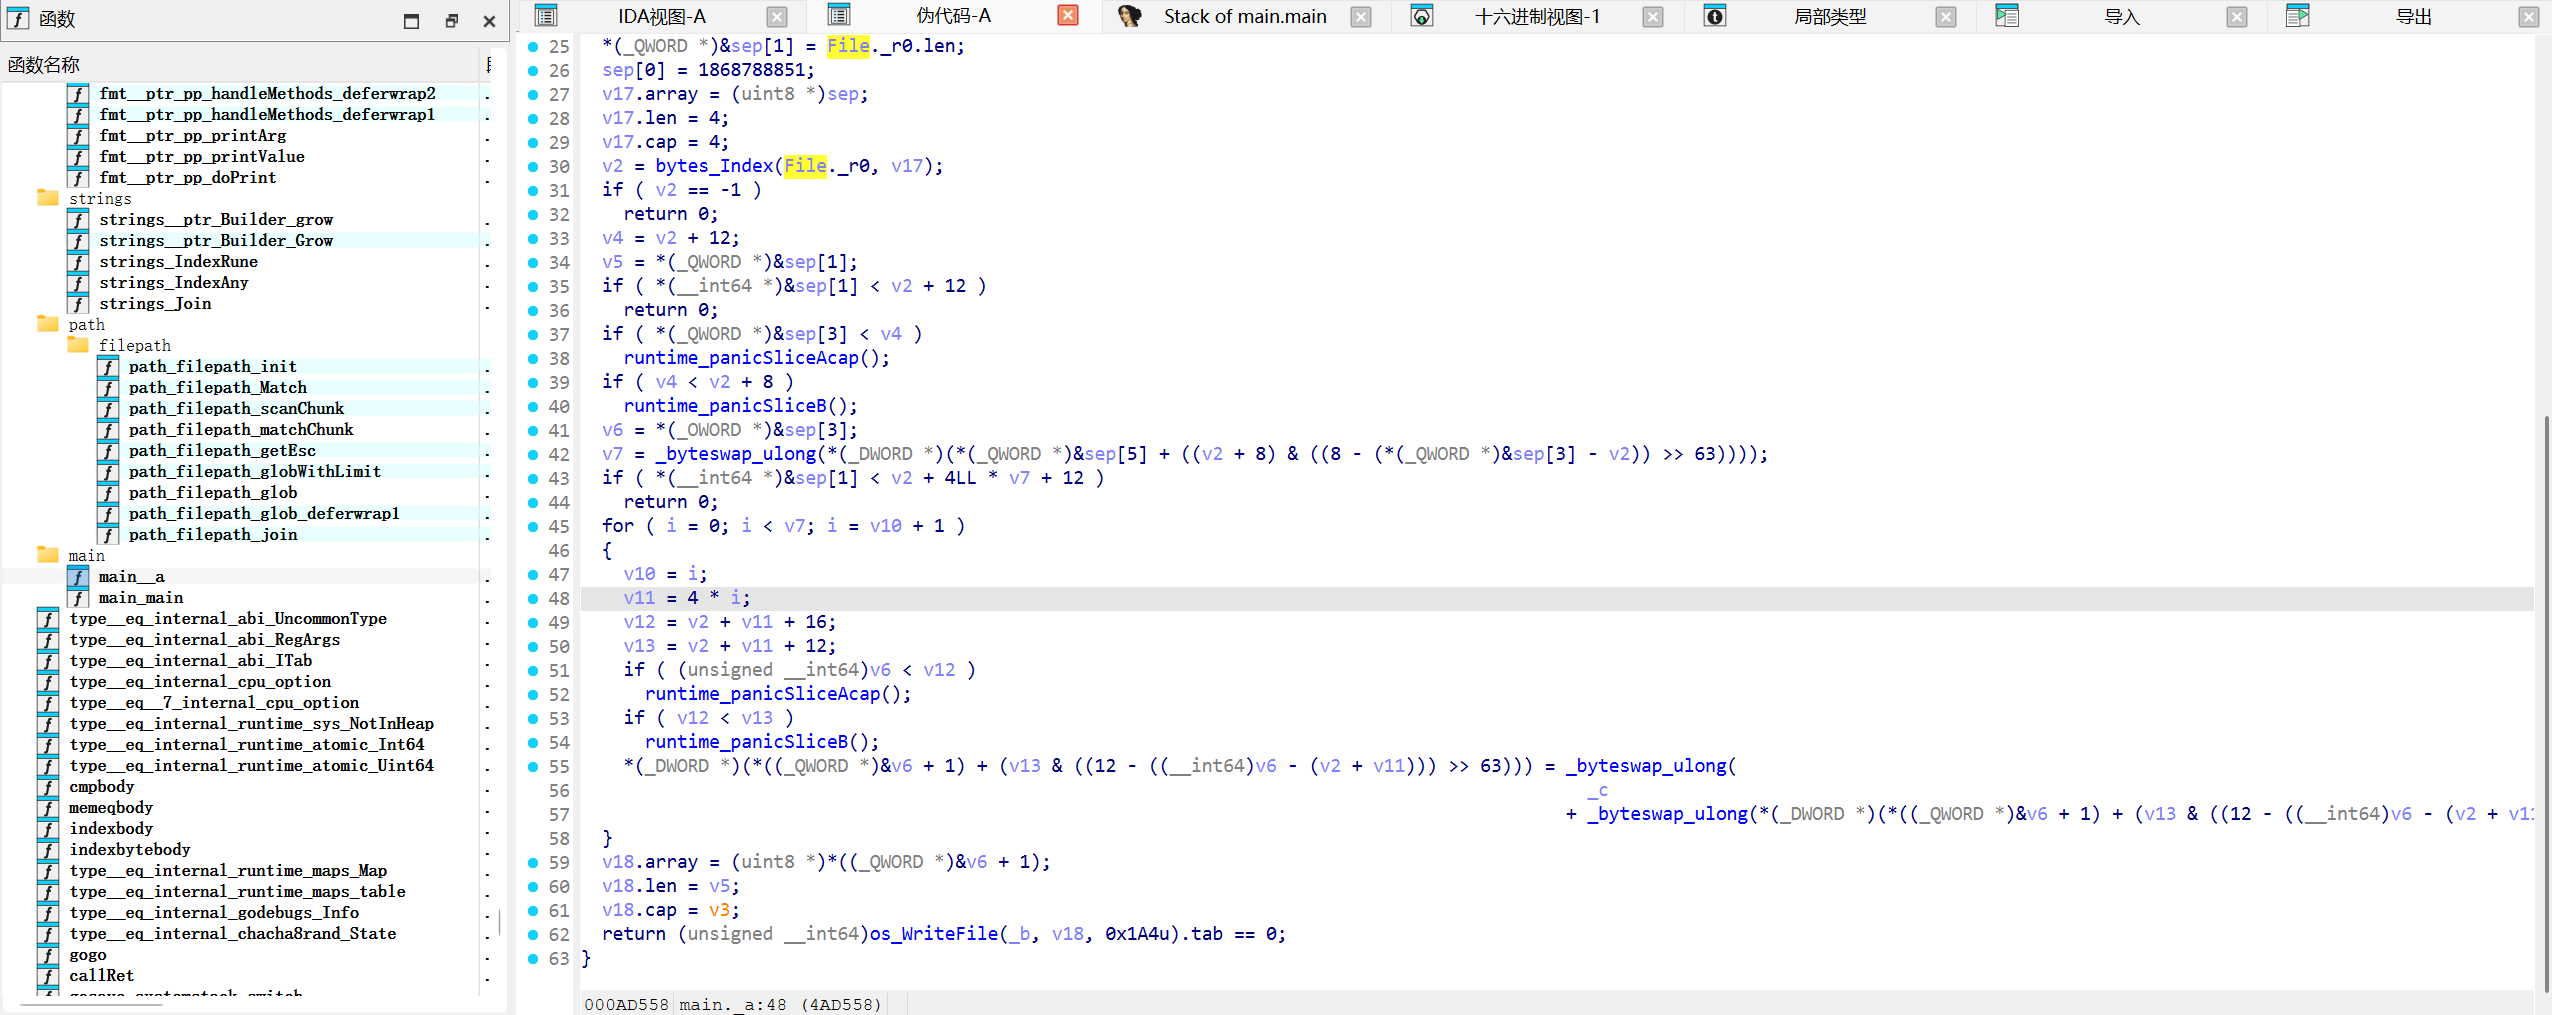
所以我们继续跟到main_a来看看

关键在这边
专门找mp4的stco

然后读取了stco+8的4字节,循环
for (i = 0; i < v7; i++)
{
    offset = v2 + 12 + 4 * i;
    value = big_endian_u32(data[offset:offset+4]);
    value = value + _c;
    write_big_endian_u32(offset, value);
}
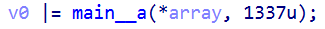
简单来说就是把stco表里的每一个chunk_offset都加了1337
加1337加密,那减1337就是解密了
#!/usr/bin/env python3
import sys
import struct
from pathlib import Path

KEY = 0x539  # 1337

def decrypt_one(path: Path, out_path: Path | None = None) -> bool:
    data = bytearray(path.read_bytes())

    idx = data.find(b"stco")
    if idx == -1:
        print(f"[-] {path}: not found stco")
        return False

    if len(data) < idx + 12:
        print(f"[-] {path}: invalid stco structure")
        return False

    entry_count = struct.unpack(">I", data[idx + 8:idx + 12])[0]

    table_start = idx + 12
    table_end = table_start + entry_count * 4

    if len(data) < table_end:
        print(f"[-] {path}: stco table out of range, entry_count={entry_count}")
        return False

    print(f"[+] {path}: stco at 0x{idx:x}, entry_count={entry_count}")

    for i in range(entry_count):
        pos = table_start + i * 4
        old = struct.unpack(">I", data[pos:pos + 4])[0]

        if old < KEY:
            print(f"[!] {path}: offset too small at entry {i}, old={old}, skip")
            continue

        new = old - KEY
        data[pos:pos + 4] = struct.pack(">I", new)

    if out_path is None:
        out_path = path.with_name(path.stem + "_decrypted" + path.suffix)

    out_path.write_bytes(data)
    print(f"[+] saved: {out_path}")
    return True

def main():
    if len(sys.argv) < 2:
        print("Usage:")
        print("  python decrypt_mp4.py encrypted.mp4")
        print("  python decrypt_mp4.py *.mp4")
        return

    for name in sys.argv[1:]:
        path = Path(name)
        if not path.is_file():
            print(f"[-] not file: {path}")
            continue
        decrypt_one(path)

if __name__ == "__main__":
    main()
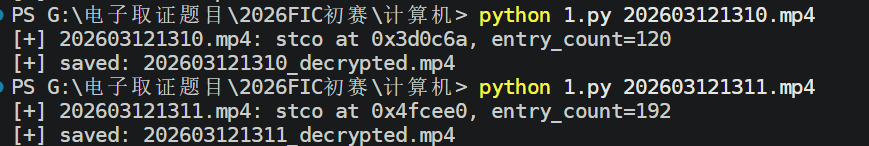
得到解密的mp4了
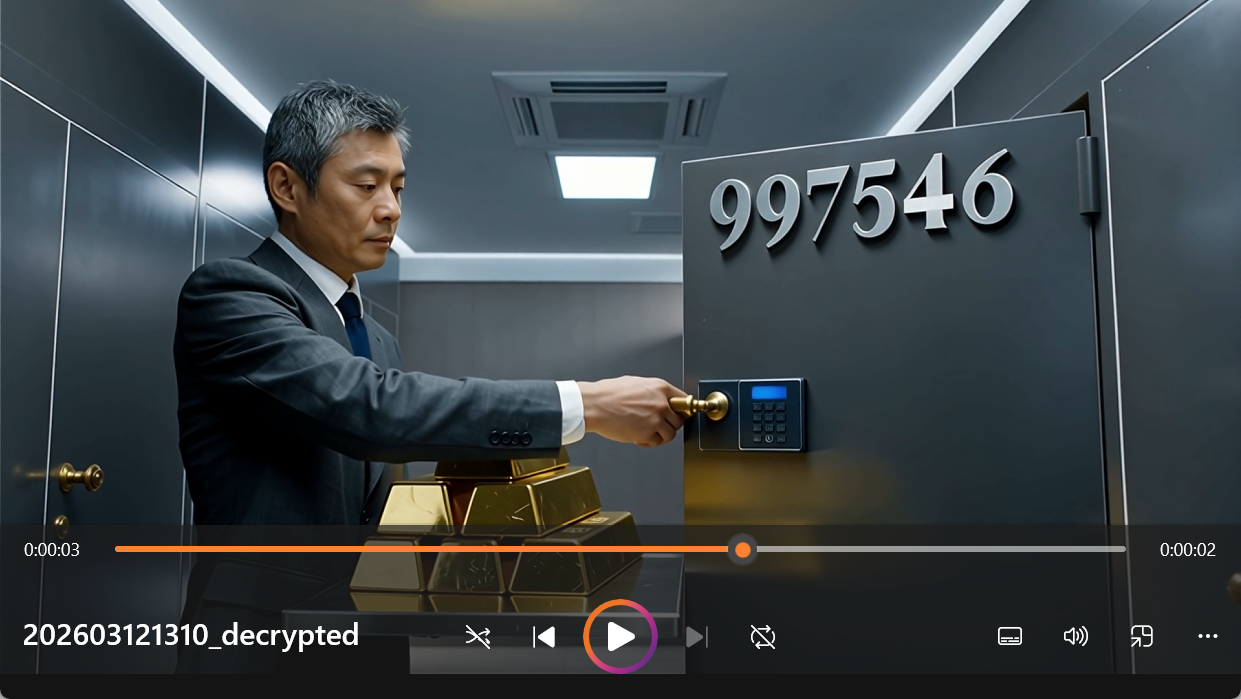
打开就看见密码了997546

其实.hidden文件提示了就是这一个mp4,和另一个无关,但是解都在解了一起解密算了
10. 分析计算机检材,李安弘电脑中记录的保险柜密码是

直接搜就能搜到保险箱的秘密,明显这题和这个有关,我们去看看
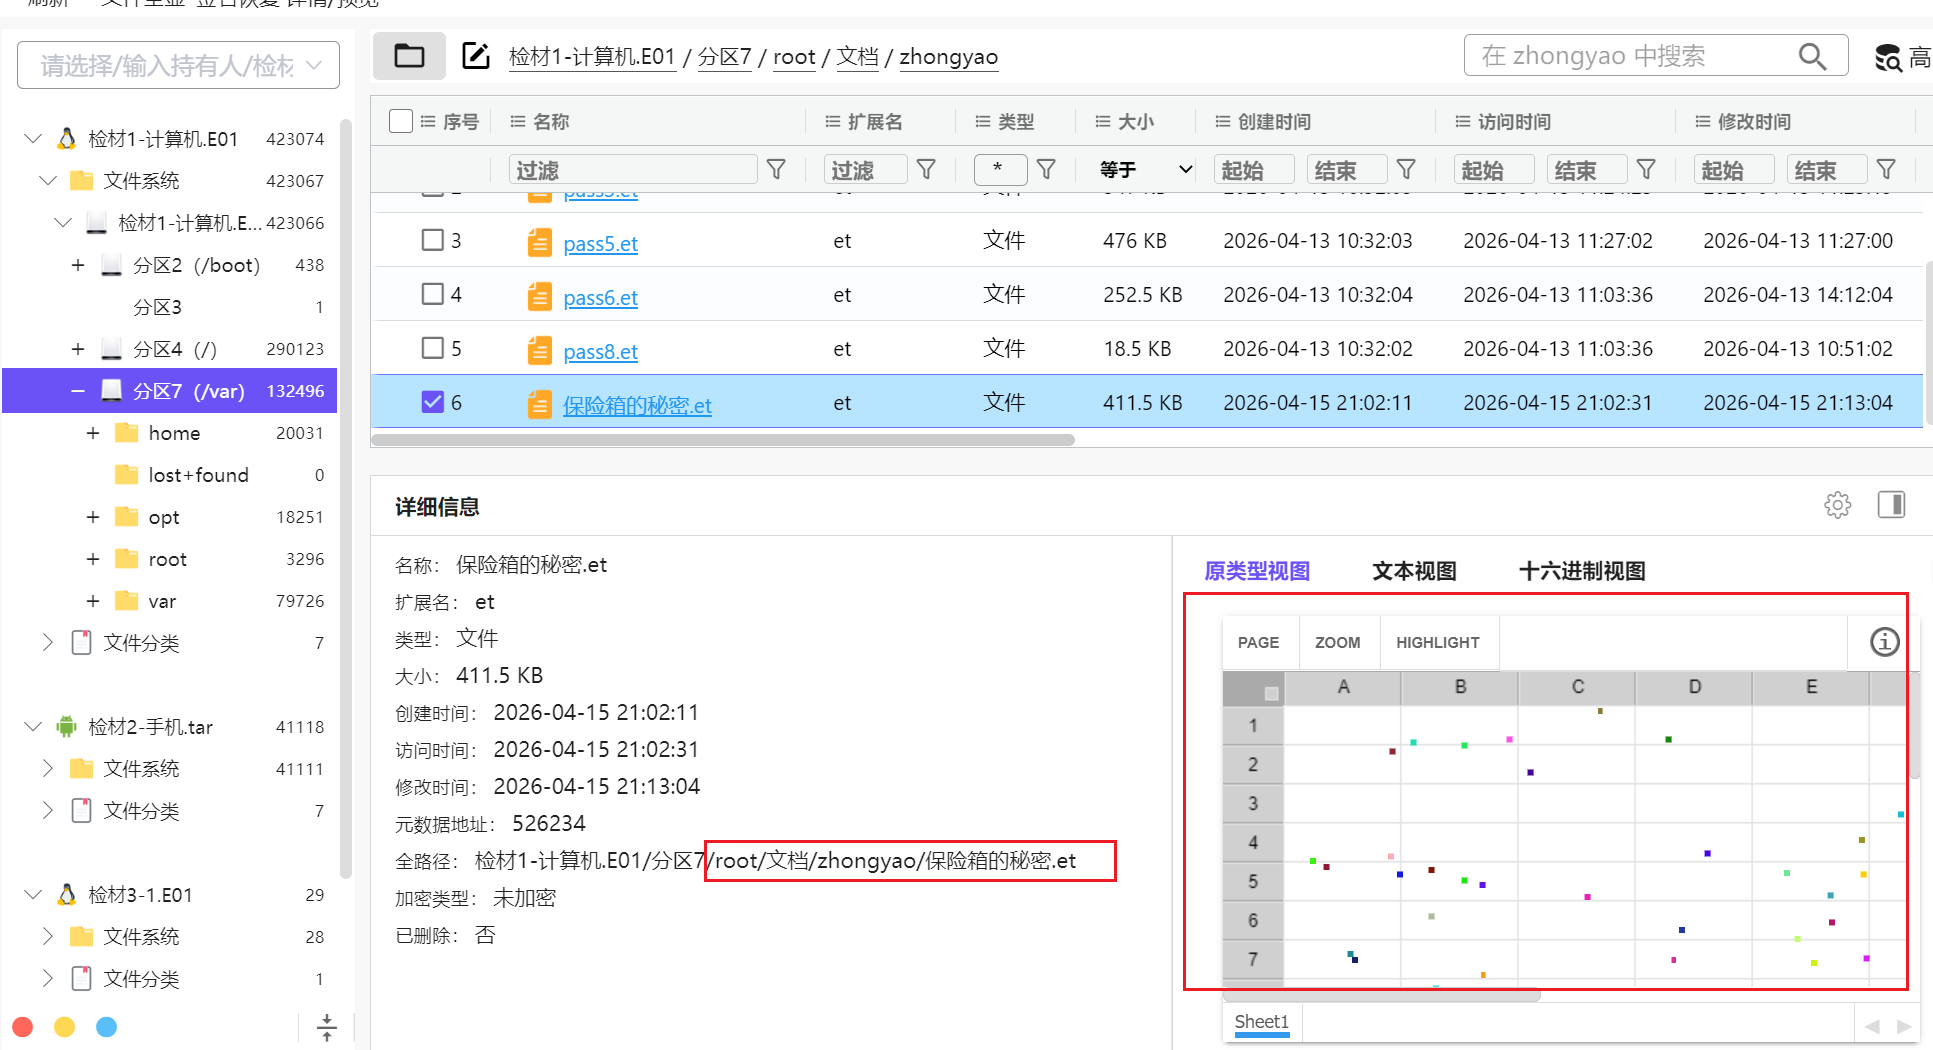
发现在这个/root/文档/zhongyao下边,加密起来了,是一个excel
一下子没有头绪

发现对方在电脑上反复搜索如何加密excel,猜测可能电脑上就存在加密脚本
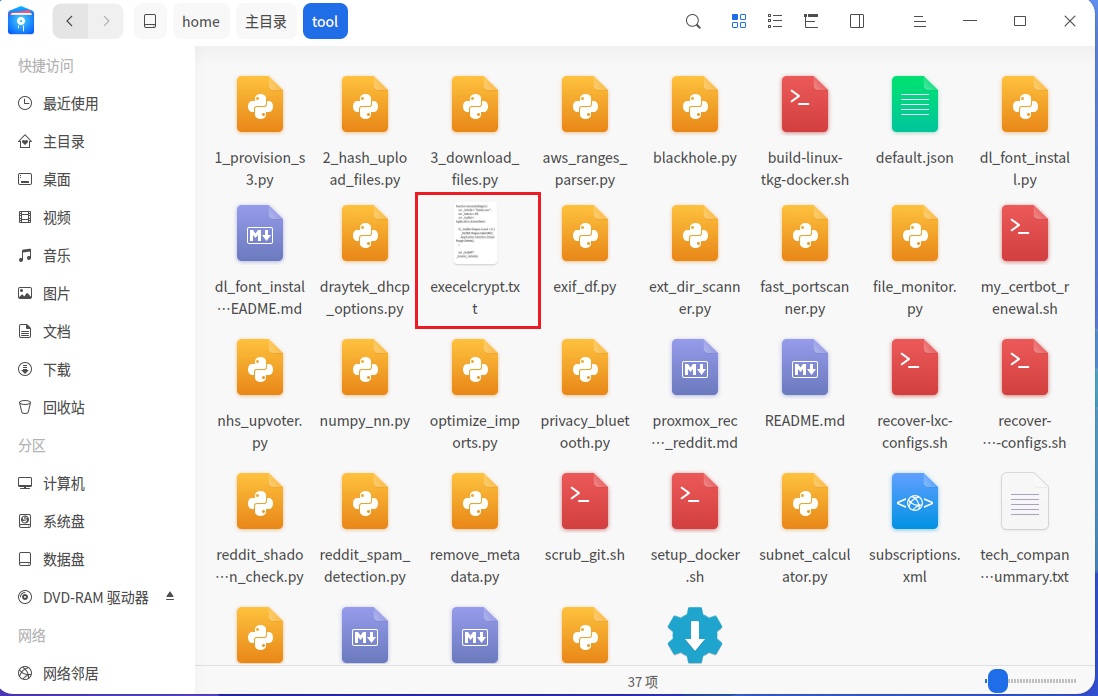
在tool果然找到一个,很显眼的加密excel程序
加密逻辑主要是
encoded = (((x + 100) ^ 85) * 1000) + ((y + 100) ^ 85)
所以我们只需要
x = ((encoded // 1000) ^ 85) - 100
y = ((encoded % 1000) ^ 85) - 100
即可解密
根据这个写一个解密的就好了
#!/usr/bin/env python3
-- coding: utf-8 --
import re
import sys
import struct
from pathlib import Path
from collections import defaultdict
KEY = 85
BASE = 100
STEP = 25
DOT = 4
FONT = {
'0': [[1,0],[2,0],[0,1],[3,1],[0,2],[3,2],[0,3],[3,3],[1,4],[2,4]],
'1': [[2,0],[1,1],[2,1],[2,2],[2,3],[1,4],[2,4],[3,4]],
'2': [[1,0],[2,0],[0,1],[3,1],[2,2],[1,3],[0,4],[1,4],[2,4],[3,4]],
'3': [[0,0],[1,0],[2,0],[3,1],[1,2],[2,2],[3,3],[0,4],[1,4],[2,4]],
'4': [[3,0],[2,1],[3,1],[1,2],[3,2],[0,3],[1,3],[2,3],[3,3],[4,3],[3,4]],
'5': [[0,0],[1,0],[2,0],[0,1],[0,2],[1,2],[2,2],[3,3],[0,4],[1,4],[2,4]],
'6': [[1,0],[2,0],[0,1],[0,2],[1,2],[2,2],[0,3],[3,3],[1,4],[2,4]],
'7': [[0,0],[1,0],[2,0],[3,0],[3,1],[2,2],[1,3],[1,4]],
'8': [[1,0],[2,0],[0,1],[3,1],[1,2],[2,2],[0,3],[3,3],[1,4],[2,4]],
'9': [[1,0],[2,0],[0,1],[3,1],[1,2],[2,2],[3,2],[3,3],[2,4]],
'a': [[1,2],[2,2],[3,2],[0,3],[3,3],[1,4],[2,4],[3,4]],
'b': [[0,0],[0,1],[0,2],[1,2],[2,2],[0,3],[3,3],[0,4],[1,4],[2,4]],
'c': [[1,0],[2,0],[3,0],[0,1],[0,2],[0,3],[1,4],[2,4],[3,4]],
'd': [[3,0],[3,1],[1,2],[2,2],[3,2],[0,3],[3,3],[1,4],[2,4],[3,4]],
'e': [[1,0],[2,0],[0,1],[0,2],[1,2],[2,2],[0,3],[1,4],[2,4]],
'f': [[1,0],[2,0],[1,1],[0,2],[1,2],[2,2],[1,3],[1,4]],
'g': [[1,2],[2,2],[3,2],[0,3],[3,3],[1,4],[2,4],[3,4],[3,5],[1,6],[2,6]],
'h': [[0,0],[0,1],[0,2],[1,2],[2,2],[0,3],[3,3],[0,4],[3,4]],
'i': [[1,0],[1,2],[1,3],[1,4]],
'j': [[2,0],[2,2],[2,3],[2,4],[2,5],[1,6],[0,5]],
'k': [[0,0],[0,1],[0,2],[0,3],[0,4],[2,2],[1,3],[3,3],[2,4]],
'l': [[1,0],[1,1],[1,2],[1,3],[1,4]],
'm': [[0,1],[1,1],[2,1],[3,1],[4,1],[0,2],[2,2],[4,2],[0,3],[4,3]],
'n': [[0,1],[1,0],[2,0],[0,2],[3,2],[0,3],[3,3],[0,4],[3,4]],
'o': [[1,1],[2,1],[0,2],[3,2],[1,3],[2,3]],
'p': [[0,2],[1,2],[2,2],[0,3],[3,3],[0,4],[1,4],[2,4],[0,5],[0,6]],
'q': [[1,2],[2,2],[0,3],[3,2],[3,3],[3,4],[3,5],[4,5]],
'r': [[0,2],[0,3],[0,4],[1,2],[2,2]],
's': [[1,0],[2,0],[3,0],[0,1],[1,2],[2,2],[3,3],[0,4],[1,4],[2,4]],
't': [[1,0],[1,1],[1,2],[1,3],[1,4],[0,2],[2,2]],
'u': [[0,2],[0,3],[3,2],[3,3],[1,4],[2,4],[3,4]],
'v': [[0,0],[4,0],[1,2],[3,2],[2,4]],
'w': [[0,2],[0,3],[1,4],[2,3],[3,4],[4,2],[4,3]],
'x': [[0,0],[4,0],[1,1],[3,1],[2,2],[1,3],[3,3],[0,4],[4,4]],
'y': [[0,0],[4,0],[1,1],[3,1],[2,2],[2,3],[1,4]],
'z': [[0,0],[1,0],[2,0],[3,0],[2,1],[1,2],[0,3],[0,4],[1,4],[2,4],[3,4]],

':': [[1,1],[1,3]],
'@': [[1,0],[2,0],[0,1],[3,1],[0,2],[2,2],[3,2],[0,3],[1,4],[2,4]],
'.': [[1,4]],
}
REV_FONT = {
tuple(sorted(map(tuple, points))): ch
for ch, points in FONT.items()
}
def read_ole_workbook(path: Path) -> bytes:
data = path.read_bytes()
if data[:8] != bytes.fromhex("d0 cf 11 e0 a1 b1 1a e1"):
    raise ValueError("不是 OLE/CFB 格式,可能不是 .et/.xls 文件")

END = 0xFFFFFFFE
FREE = 0xFFFFFFFF

header = data[:512]
sector_size = 1 << struct.unpack_from("<H", header, 30)[0]
first_dir_sector = struct.unpack_from("<I", header, 48)[0]

fat_sectors = list(struct.unpack_from("<109I", header, 76))
fat_sectors = [x for x in fat_sectors if x not in (FREE, END)]

fat = []
for sec in fat_sectors:
    off = 512 + sec * sector_size
    fat.extend(struct.unpack_from("<%dI" % (sector_size // 4), data, off))

def read_chain(start_sector: int) -> bytes:
    out = bytearray()
    seen = set()
    sec = start_sector

    while sec not in (END, FREE) and sec < len(fat) and sec not in seen:
        seen.add(sec)
        off = 512 + sec * sector_size
        out.extend(data[off:off + sector_size])
        sec = fat[sec]

    return bytes(out)

directory = read_chain(first_dir_sector)

for i in range(0, len(directory), 128):
    entry = directory[i:i + 128]
    if len(entry) < 128:
        continue

    name_len = struct.unpack_from("<H", entry, 64)[0]
    if name_len < 2:
        continue

    name = entry[:name_len - 2].decode("utf-16le", errors="ignore")
    obj_type = entry[66]
    start_sector = struct.unpack_from("<I", entry, 116)[0]
    size = struct.unpack_from("<Q", entry, 120)[0]

    if obj_type == 2 and name in ("Workbook", "Book"):
        return read_chain(start_sector)[:size]

raise ValueError("没有找到 Workbook/Book 流")
def extract_encoded_numbers(blob: bytes):
"""
WPS .et 里 Shape.AlternativeText 被保存成 UTF-16LE 数字字符串。
例如:49049、61057、377037 这种。
"""
nums = []
for m in re.finditer(rb"(?:[0-9]\x00){4,9}", blob):
    try:
        s = m.group().decode("utf-16le")
        nums.append(int(s))
    except Exception:
        pass

return nums
def decode_number(n: int):
left = n
