容器密码:VeZeTANHVkklvVljLnpOYeBwCJFYD5tFpf67f5kNuqP1G5jj
服务器
PVE集群安装配置介绍:https://zhuanlan.zhihu.com/p/617024637
PVE = VMware ESXi + Docker + Linux 运维工具 的融合体。
物理服务器
│
├── CPU
├── 内存
├── 硬盘
└── 网卡
      │
      ▼
PVE(使用pveqm管理整个节点)
│
├── KVM 虚拟机(使用qm管理KVM虚拟机)
│     ├── Windows
│     ├── Ubuntu
│     └── CentOS
│
└── LXC 容器(使用pct管理LXC容器)
      ├── nginx
      ├── mysql
      └── redis
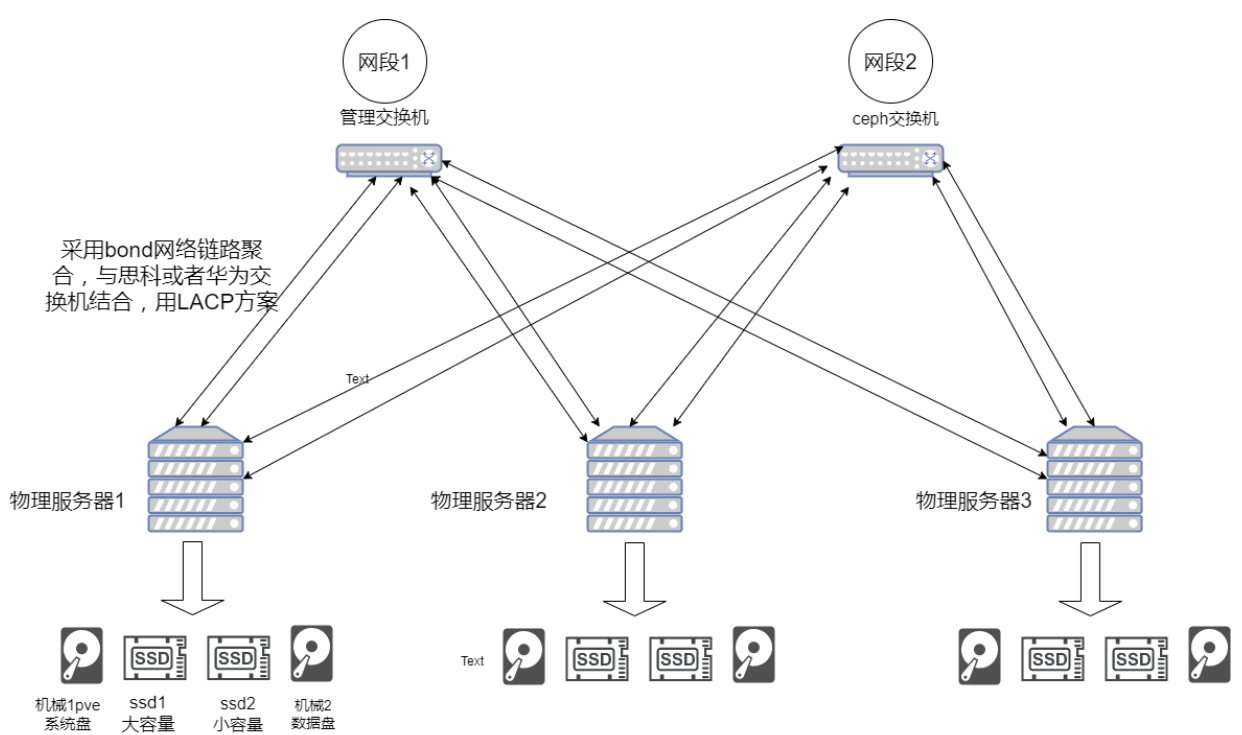
总体先说一下PVE的网络规则,首先得有两张真实网卡,一张网卡桥接在vmbr0做普通网络的通信。还要再多设置一张网卡桥接在vmbr1上做Ceph网络专门用于存储网络。因为PVE集群的性能节点就在存储上,占CPU不高但非常吃存储,所以要专门为Ceph配置一个专门的存储网络。拓扑图如下
集群服务器通信问题:
查看pvecm status发现其他几台机器都不在集群中,也ping不通,可能是网络问题。网络通信问题不会的把网络配置文件丢给AI读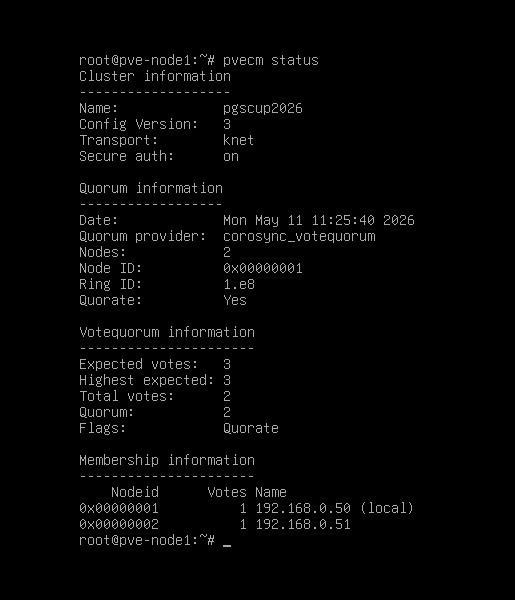
查看ip a,这里本来ens160网卡是down的问题出在这。ip link set ens160 up先把ens160打开。
物理网卡是ens,vmbr应该是kvm虚拟机的桥接网卡。像lxc的话桥接网卡就取名为lxcbr


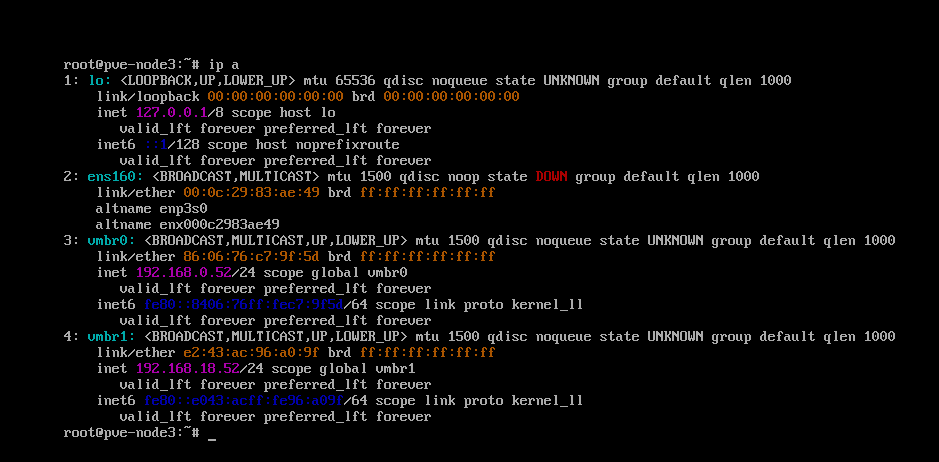
再修改/etc/network/interfaces(网卡配置文件)里的bridge-ports为ens160,一开始不是这张网卡,所以没挂上自然连接不了。这里网络配置就是这样的不使用原本的ens网卡,而是将网络桥接至vmbr0和vmbr1。
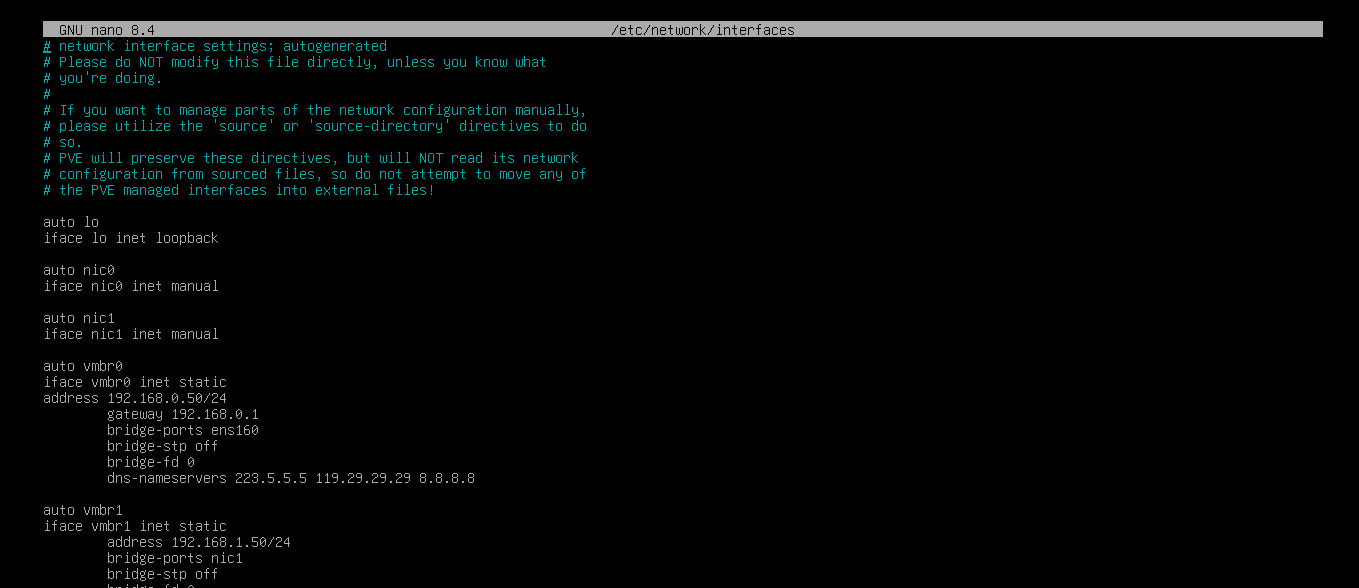
最后systemctl restart networking
验证一下,互相ping
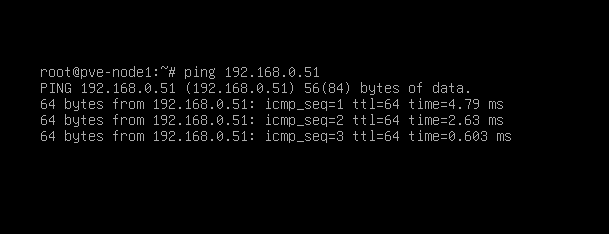
然后就是解决Ceph网络问题,先看下配置ceph.conf,要把vmbr1都配置成170网段,再添加张170段的VM2网卡为vmbr1做桥接。配置vmbr1的步骤同vmbr1。也可以直接键入如下命令桥接上网卡。
# pve-node1 (170.50 → 0.50)ip addr add 192.168.170.50/24 dev vmbr1
# pve-node2 (170.51 → 0.51)ip addr add 192.168.170.51/24 dev vmbr1
# pve-node3 (170.52 → 0.52)ip addr add 192.168.170.52/24 dev vmbr1

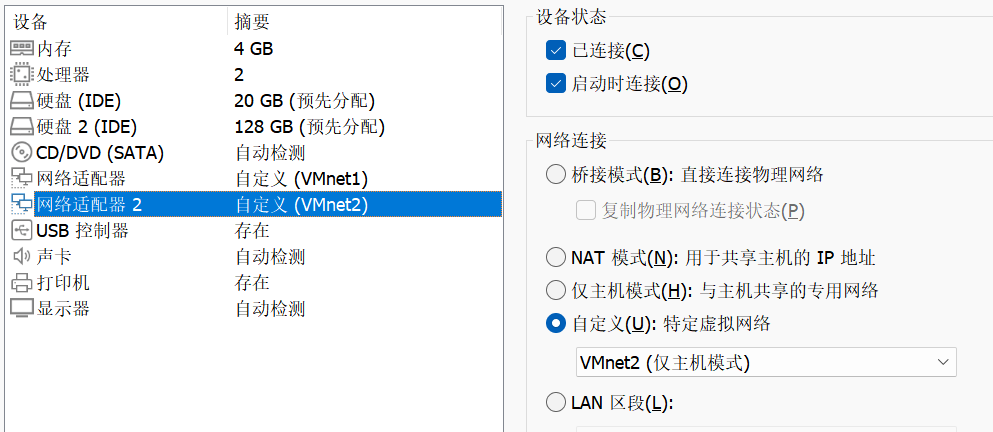
两个网络都可以互通了,但是Web虚拟机还无法启动,让codex帮我排查一下问题
后来虽然网络通了,但服务没有自动恢复。
systemctl list-units 'ceph-mon@*' 'ceph-mgr@*' 'ceph-osd@*'查到后面*后的内容
对三台节点做了这些处理:
systemctl reset-failed ceph-mon@* ceph-mgr@* ceph-osd@*
systemctl restart ceph-mon@...
systemctl restart ceph-mgr@...
systemctl restart ceph-osd@...
然后 VM 100 还是启动失败,新的真实原因是:
kvm: cannot set up guest memory 'pc.ram': Cannot allocate memory
你的 pve-node1 只有约 3.8GiB 内存,但 VM 100 原来配置了:
所以它分配不了8G。我已经临时把 VM 100 内存降到 1024 MB,现在 VM 100 可以启动,QMP 也正常:
直接成功了,但是web机器登录进去需要账号密码
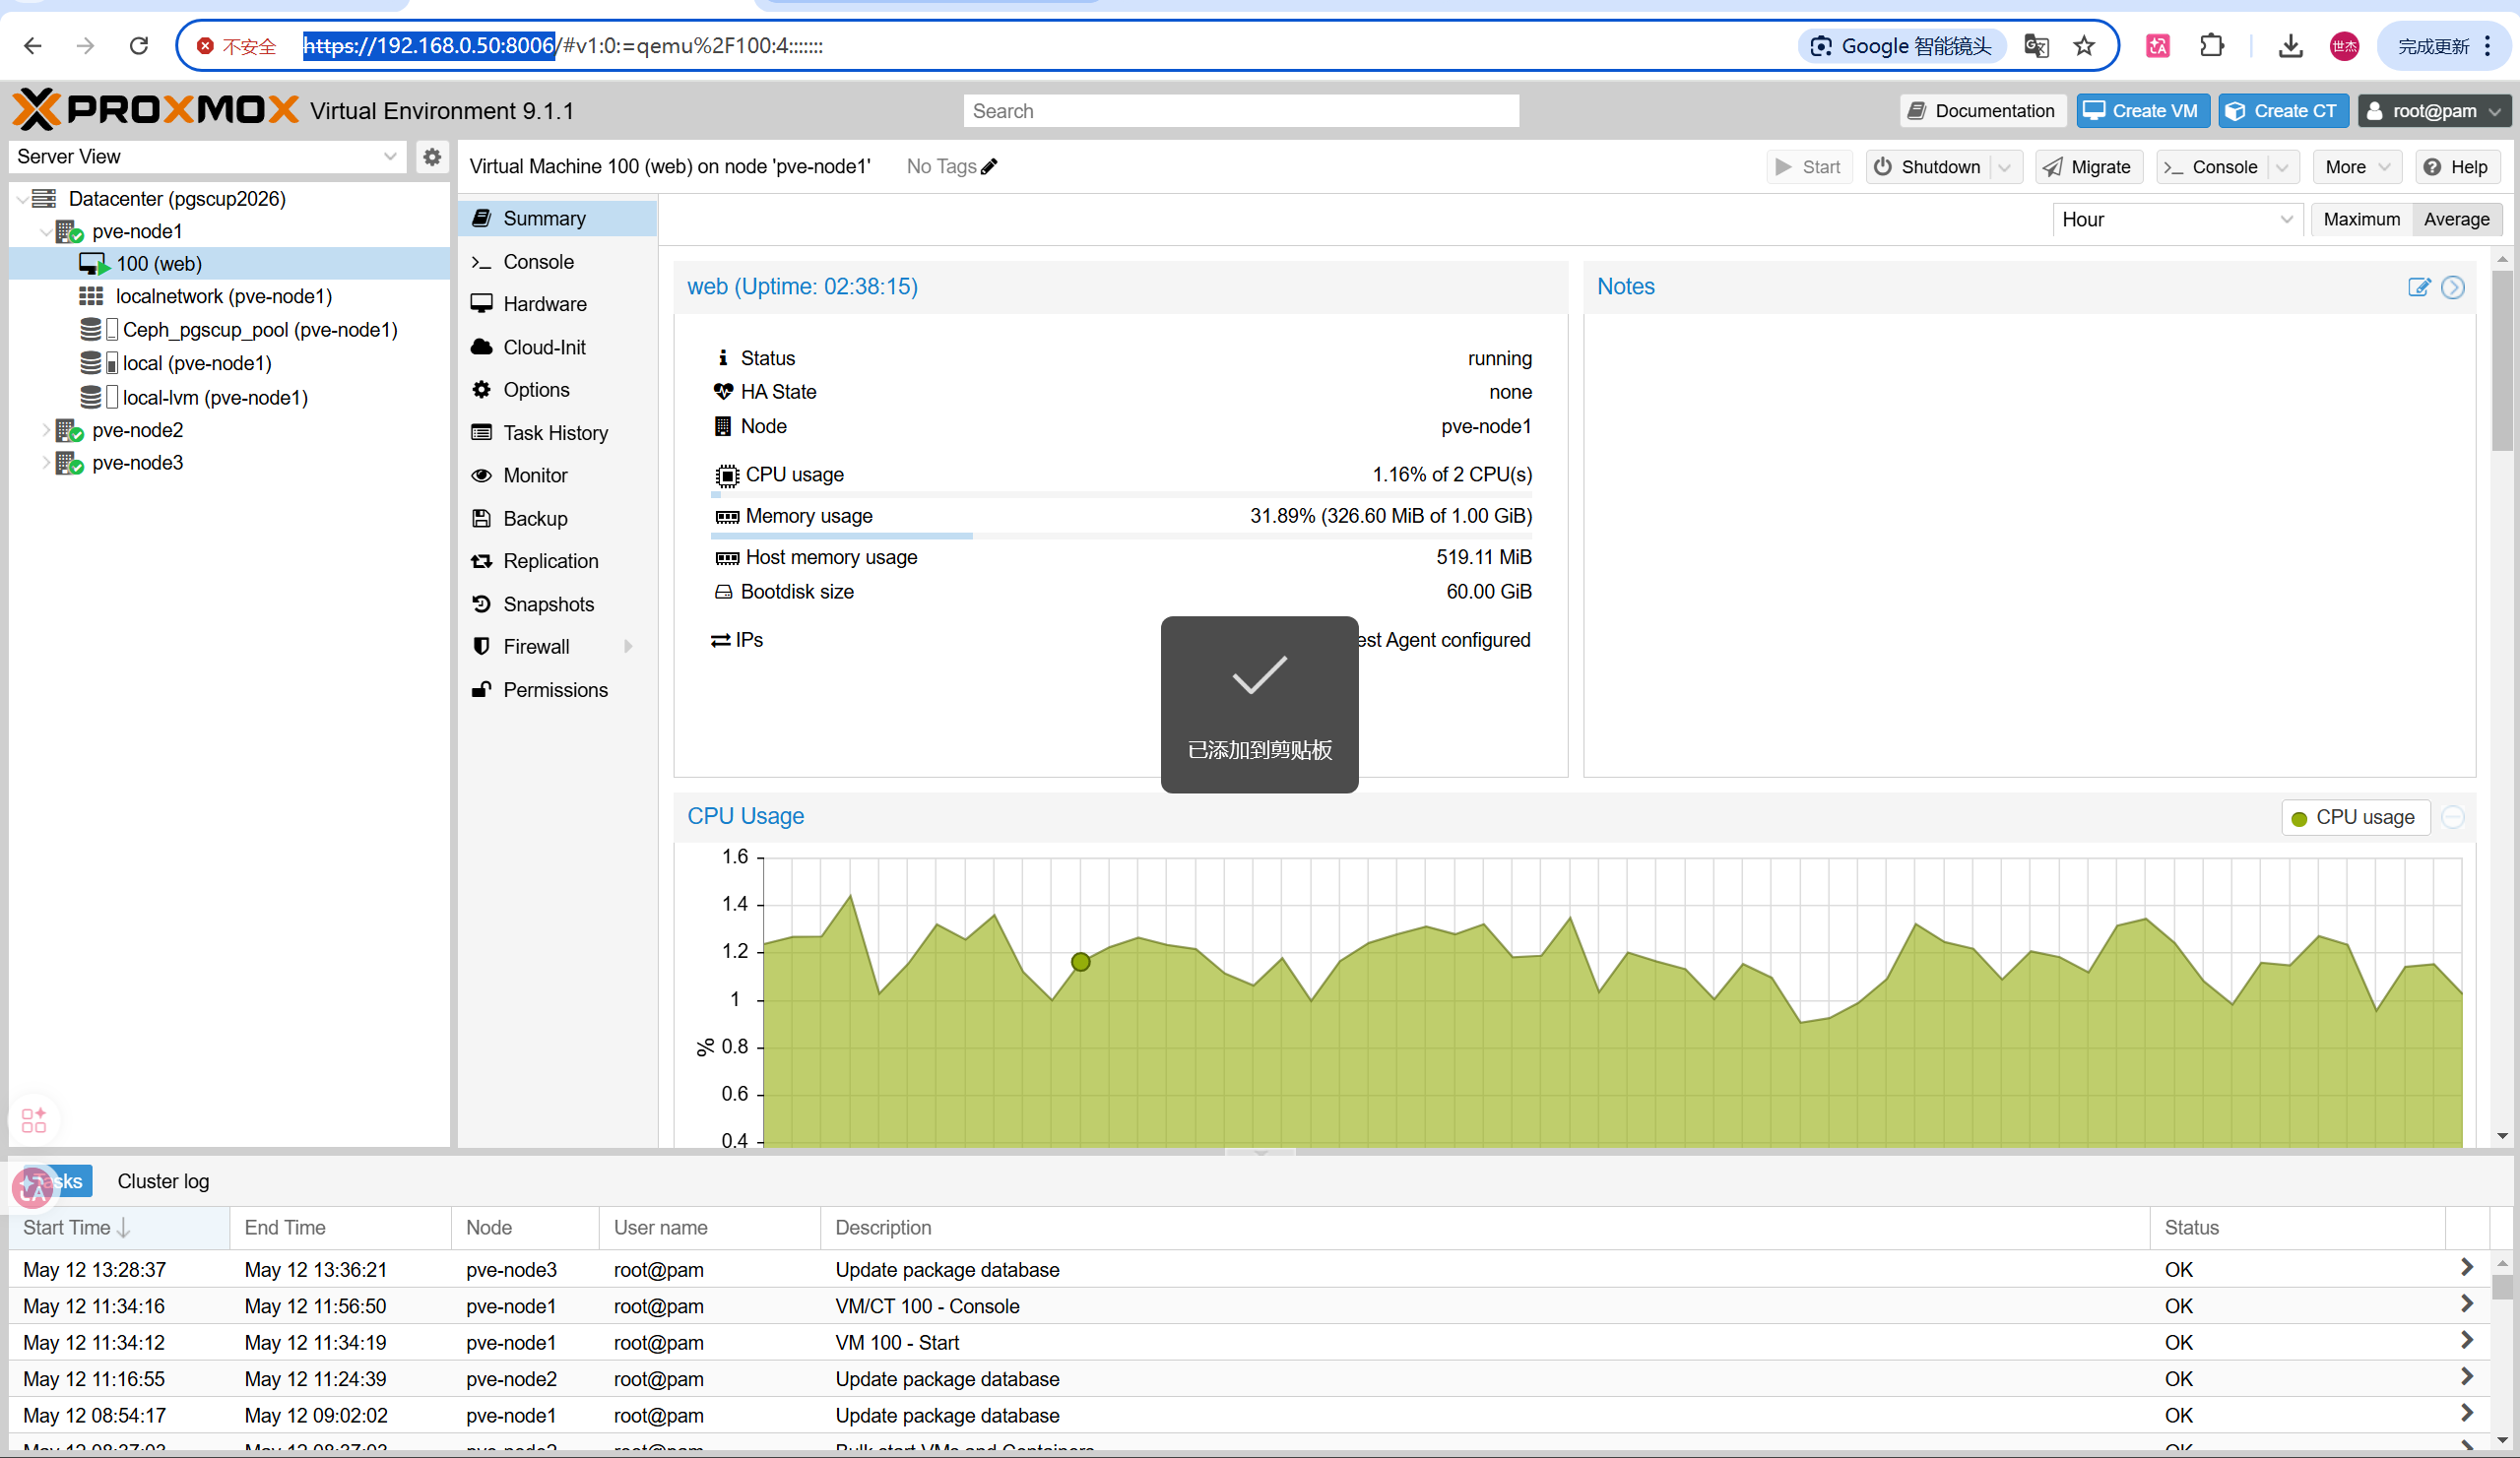
https://www.cnblogs.com/lyydbk/p/19757080 龙信杯服务器部分。卡在web这台虚拟机进不去,这里问了群里的师傅说是可以像龙信杯的esxi这样导出虚拟机镜像在火眼里重置密码
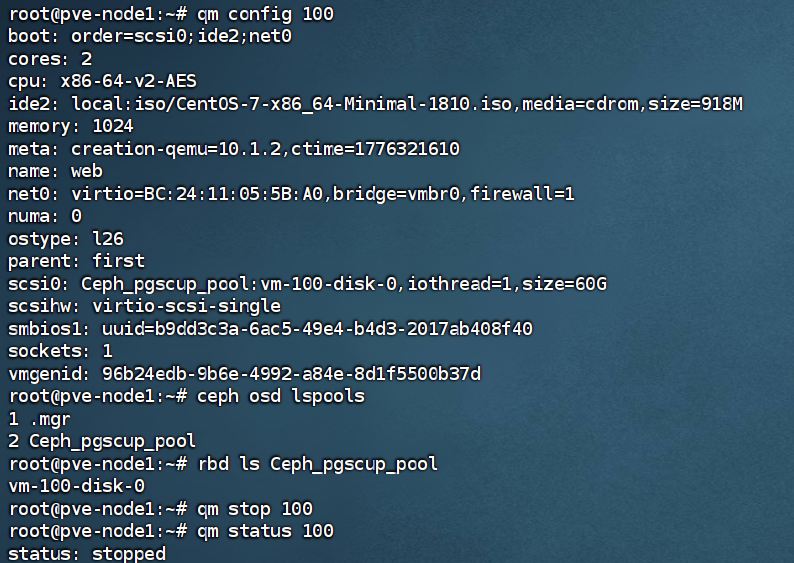
qm config 100先看看配置
boot: order=scsi0;ide2;net0
cores: 2
cpu: x86-64-v2-AES
ide2: local:iso/CentOS-7-x86_64-Minimal-1810.iso,media=cdrom,size=918M
memory: 1024
meta: creation-qemu=10.1.2,ctime=1776321610
name: web
net0: virtio=BC:24:11:05:5B:A0,bridge=vmbr0,firewall=1
numa: 0
ostype: l26
parent: first
scsi0: Ceph_pgscup_pool:vm-100-disk-0,iothread=1,size=60G   #这里有一个60G的磁盘
scsihw: virtio-scsi-single
smbios1: uuid=b9dd3c3a-6ac5-49e4-b4d3-2017ab408f40
sockets: 1
vmgenid: 96b24edb-9b6e-4992-a84e-8d1f5500b37d
ceph osd lspools:列出存储池
1 .mgr
2 Ceph_pgscup_pool
rbd ls Ceph_pgscup_pool:查看 Ceph_pgscup_pool 这个 pool 里有哪些虚拟磁盘
vm-100-disk-0
这里拓展一下PVE集群的管理存储命令
ceph命令学习
ceph -s  集群状态
ceph health  健康信息
ceph osd pool ls  列出所有池名称
rbd export  导出虚拟磁盘
rbd ls <pool>  列出池中所有 RBD 镜像
rbd export <pool>/<image> <local-file>  导出镜像为本地文件(raw 格式)
这里由于pve1节点磁盘空间不足没法导出web的镜像到本机火眼直接绕密分析。
现在采用第二种方法
单行绕过虚拟机密码
Console控制台启动机器的时候长按Esc进入在 GRUB 菜单中,用箭头键选择第一行
按e键进入编辑模式。
找到以linux16开头的行。将光标移动到此行的末尾,先按空格键,然后添加 rd.break。这会让系统在初始化早期进入一个紧急 shell。
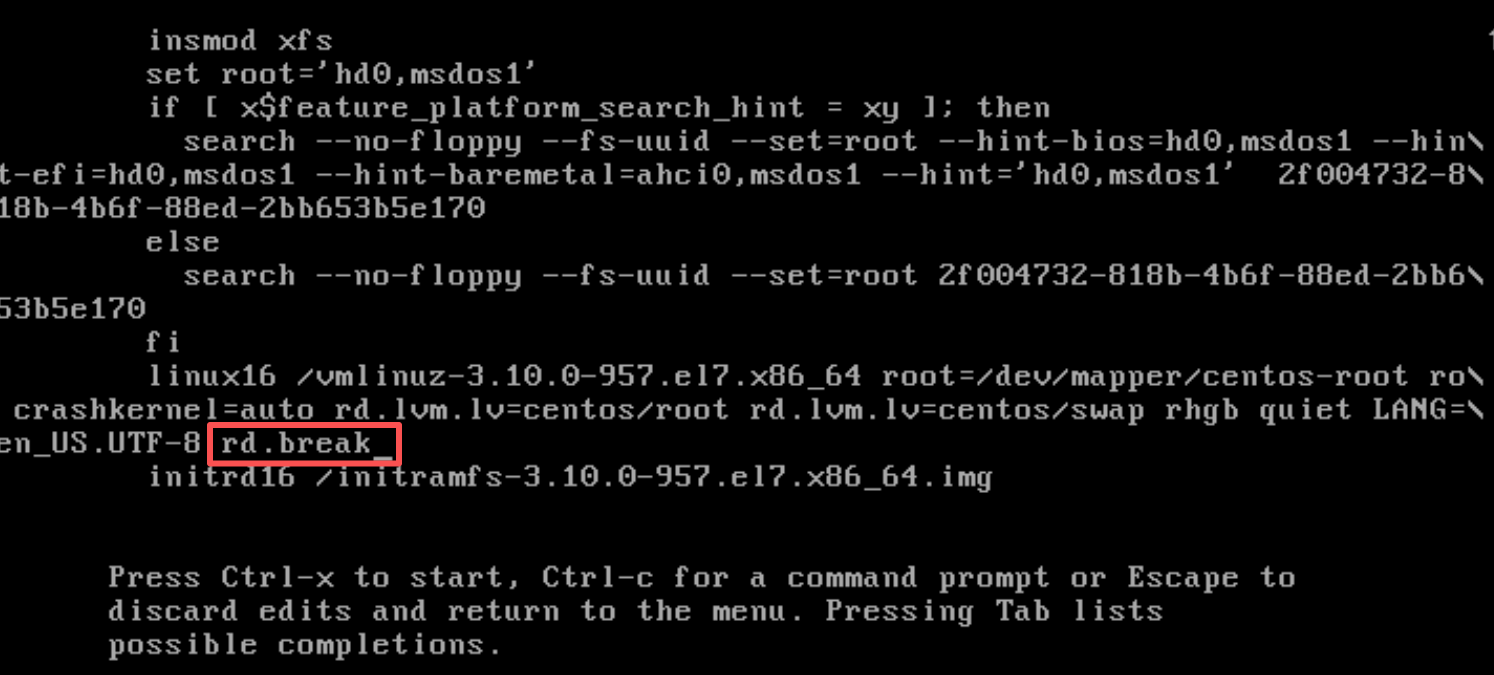
修改后,按Ctrl+ X 或F10启动系统。
系统启动后会进入一个紧急模式的 shell,提示符为 switch_root:/#。
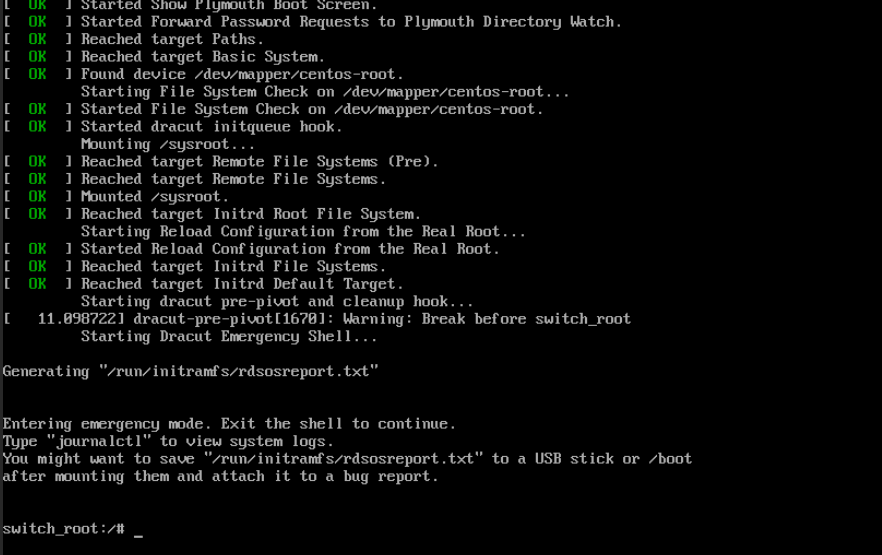
执行以下命令重新挂载根文件系统为可写:mount -o remount,rw /sysroot
切换根目录:chroot /sysroot
现在可以修改 root 密码:passwd root
输入新密码两次(输入时不会显示,注意大小写)。
如果系统启用了 SELinux(默认启用),需要更新文件系统标签:touch /.autorelabel
退出 chroot 并重启:exit 、reboot
之后用ssh连接虚拟机,发现死活连不上。这样开启监听,再连2222端口看一下具体是什么原因导致连接不上
/usr/sbin/sshd -ddd -p 2222
问了AI,是centos常见ssh不上的原因,要让下面这个文件保证这些配置。
vi /etc/ssh/sshd_config
PermitRootLogin yes
PasswordAuthentication yes
UsePAM yes
UseDNS no
GSSAPIAuthentication no
